GEO 实战笔记 / 05
同一个问题问六个 AI,你会得到六个答案
有个做跨境电商的朋友做了个实验:把同一个问题分别丢给六个 AI,然后把答案底下那几行来源抄下来,并排一放——几乎不重合。这一篇要说清楚三件事:为什么六个平台的答案会不一样(因为它们的信源池根本不是一个池子)、为什么同一个问题它内部其实会被拆成十几个小问题、以及为什么你看到的那些"重合度 11%""重合度 58
本篇目录
我是醒醒,AI共学社主理人,30岁程序员转型一人公司践行者。闲鱼+小红书变现五位数,已帮500+人用AI为工作提效。不教你追工具,只帮你用AI解决问题、赋能业务。长期主义者,专注让AI真正落地到你的工作里。
GEO 实战笔记 · 第 05 篇 你现在在哪:第 2 阶 · 看懂 这一篇带你去哪:知道要按平台选战场,而不是把一套内容摊到六个地方
有个做跨境电商的朋友,上周做了件挺有意思的事。
他把同一句话,分别丢给了六个 AI:
「2026 年做家居收纳类目,供应链该怎么选?」
然后他把每个答案底下那几行来源抄了下来,并排放在一张表里。
结果他给我发了四个字:
「基本不重合。」
六份答案,二十多条来源,重在一起的只有两条。
这不是巧合。
这是这一篇要讲的事。
先说结论:一套内容打不了天下,但原因和你想的不一样
"每个平台口味不同"这句话,你可能已经听过了。
但大多数人理解得太浅——以为就是"这个爱长文、那个爱短文"这种程度。
真实情况要严重得多。
因为它不是一层差异,是三层差异叠在一起:
- 它们的信源池就不是一个池子——六个平台去翻的书架,长得都不一样
- 你的一个问题,在它内部会被拆成十几个小问题——拆法每次还可能不一样
- 而"差多少"这件事,取决于你怎么数——这一层最容易被忽略,也最容易让人做错决策
前两层解释了"为什么会不同"。
第三层解释了"为什么你看到的那些数字,可能都不是一个东西"。
下面一层一层说。
你以为的"AI",其实是六个不同的 AI
先看第一层。
大多数人对 AI 的想象是这样的:底下是一整个互联网,六家公司各自接了一根管子上去。
所以管子不一样,抽上来的水应该差不多。
不是。
更准确的比喻是:六个平台面前摆着六个不同的书架,而且其中有四个,书架本来就是自己家做的。
 同一个问题递进去,六条路走出去。你以为是一台机器,其实是六台。
这句话是本篇的第一个关键点,我展开说。
六个主流 AI,可以按"它有没有自己的内容池"分成两类:
| 平台 | 有没有自家内容池 | 池子里是什么 |
|---|---|---|
| 豆包(字节) | 有 | 今日头条、抖音、西瓜视频、快懂百科 |
| 元宝(腾讯) | 有 | 微信公众号、视频号、腾讯新闻 |
| 文心一言(百度) | 有 | 百度百科、百家号、百度知道 |
| 通义千问(阿里) | 有 | 夸克、淘宝天猫 |
| DeepSeek | 没有 | — |
| Kimi | 没有 | — |
这张表我建议你存下来。它是本篇最有工具价值的一页。
为什么这条分界线这么重要?
因为一个平台如果有自己的内容池,它就天然更容易优先从自家池子里取水。
腾讯官方在 2024 年 5 月 30 日元宝上线的发布会上,表述得非常直白:
元宝接入了微信搜一搜、搜狗搜索等搜索引擎…… 同时,内容覆盖微信公众号等腾讯生态内容及互联网权威信源。
这句话不是营销话术,是产品说明书。
翻译过来就是:在元宝这里,公众号不是"外面的网站",是"自家的书架"。
而 DeepSeek 和 Kimi 没有自家的书架——它们只能出去,满世界多源取证。
这带来两个完全不同的结论:
- 对有自家池子的四个平台:你能不能进池子,取决于你在不在它家生态里
- 对没有自家池子的两个平台:不存在"进不进池子",只存在"外面有多少个地方在替你说话"
所以"一套内容通投六个平台"这句话,从第一步就走错了。
因为你面对的根本不是六个渠道,是六套结构完全不同的规则。
(顺便说一句:这六个平台的信源偏好,网上流传的百分比数字——"元宝 65% 来自微信生态""文心一言对百度系引用率 81.7%"这一类——我在这篇里一个都没用。原因第 06 篇会专门讲。)
它还会把你的一句话拆成十几个小问题
第二层,更深一点。
就算信源池一样,答案也未必一样。
因为——你问的是一句话,但 AI 看到的不是一句话。
Google 在自己的官方文档里把这个机制写得很清楚:
AI 概览和 AI 模式都可能使用"查询扇出(query fan-out)"技术,在生成回答的过程中,针对不同子话题和数据源发起多次相关搜索。
说人话:
你把一个问题递进去,它先把它拆成十几个小问题,分头去搜,再把结果拼回一个答案。
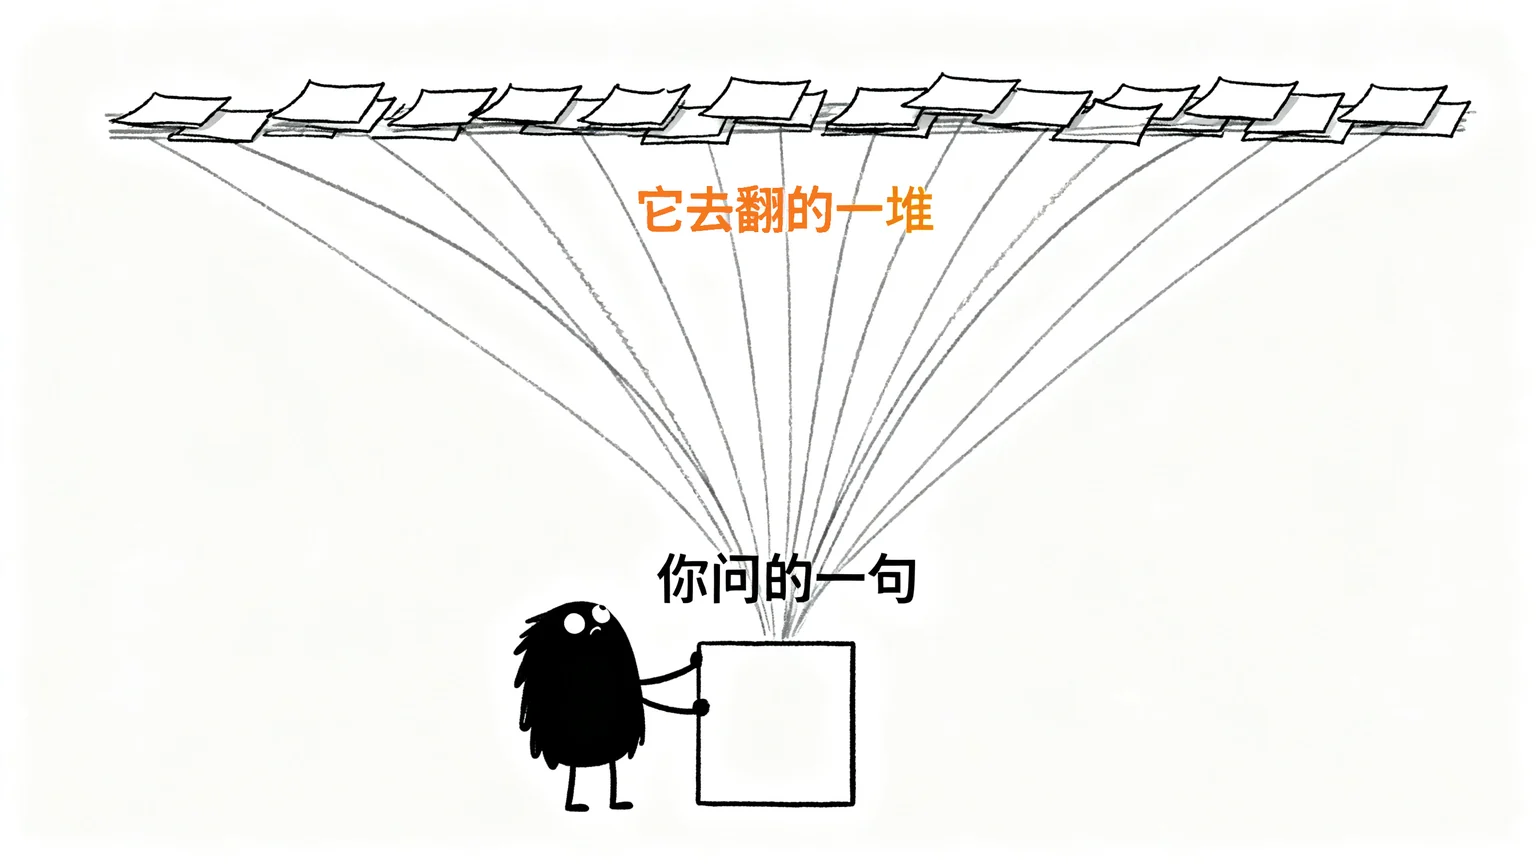 你递进去一句,它散出去一把。捡回来的不是同一把,拼出来的自然不是一个答案。
Google 产品副总裁 Robby Stein 在 2025 年 7 月的一次访谈里提到过,一次提问通常会产生 8 到 12 个并行子查询。
8 到 12 个。
这就解释了一个很多人想不通的现象:
同一个问题,你今天问和明天问,答案不一样。
因为拆法变了,搜到的书就变了。
有一家做 SEO 工具的机构测过这个稳定性,发现只有大约 27% 的扇出子查询在重复运行中保持不变。
也就是说,剩下七成多的"小问题",每次都是现拆的。
而一篇更有分量的研究——发在 ACL 2026 上的《生成式 AI 时代的网络搜索特征》——把这层差异说成了学术结论:
不同引擎在依赖内部知识还是外部检索的程度上、在来源多样性上、在稳定性上,都存在显著差异; 而且生成式搜索的输出会随时间和执行次数变化。
这篇是同行评审的。它给了一件很确定的事:
不稳定不是 bug,是这类系统的固有特征。
再补一个更扎心的数据。
有一家监测机构跟踪了 15,155 个品牌,每天跑,看它们在 Google 自己那三个不同答案界面上的可见度。
他们发现了一个可以作为"地板"的数字:
同一个模型,跟自己比——今天跑一次、明天跑一次——它提到的公司,重合度也就是刚刚过半。
同一个模型,同一个问题,隔一天。
一半都不到的地方,就已经在变了。
所以别怪 AI 记性差。它本来就不是在"记",每一步都是现算的(这一点上上篇讲过)。
那到底差多少?先别急着信那个数字
第三层,本篇最硬的一节。
我猜你现在想问的是:那到底差多少?
你去搜,会看到一堆数字:
- 有的说不同 AI 引擎引用的页面,只有 6.8% 是重合的
- 有的说近 80% 的网站只被其中一个引擎引用
- 有的说不同引擎提到同一个品牌的比例是 30.3%
- 有的说只有 11% 的域名同时被两个引擎引用
- 有的说 AI 概览和 AI 模式引用的 URL 重合 13.7%
- 有的说 Jaccard 相似度是 37.4%
- 还有的说 URL 重合 58%、域名重合 88%
看出问题了吗?
从 6.8% 到 88%,跨度超过十倍。
它们全是错的吗?
恰恰相反——它们可能全是对的。
这就是我这一节想让你带走的东西,我把它叫分母问题。
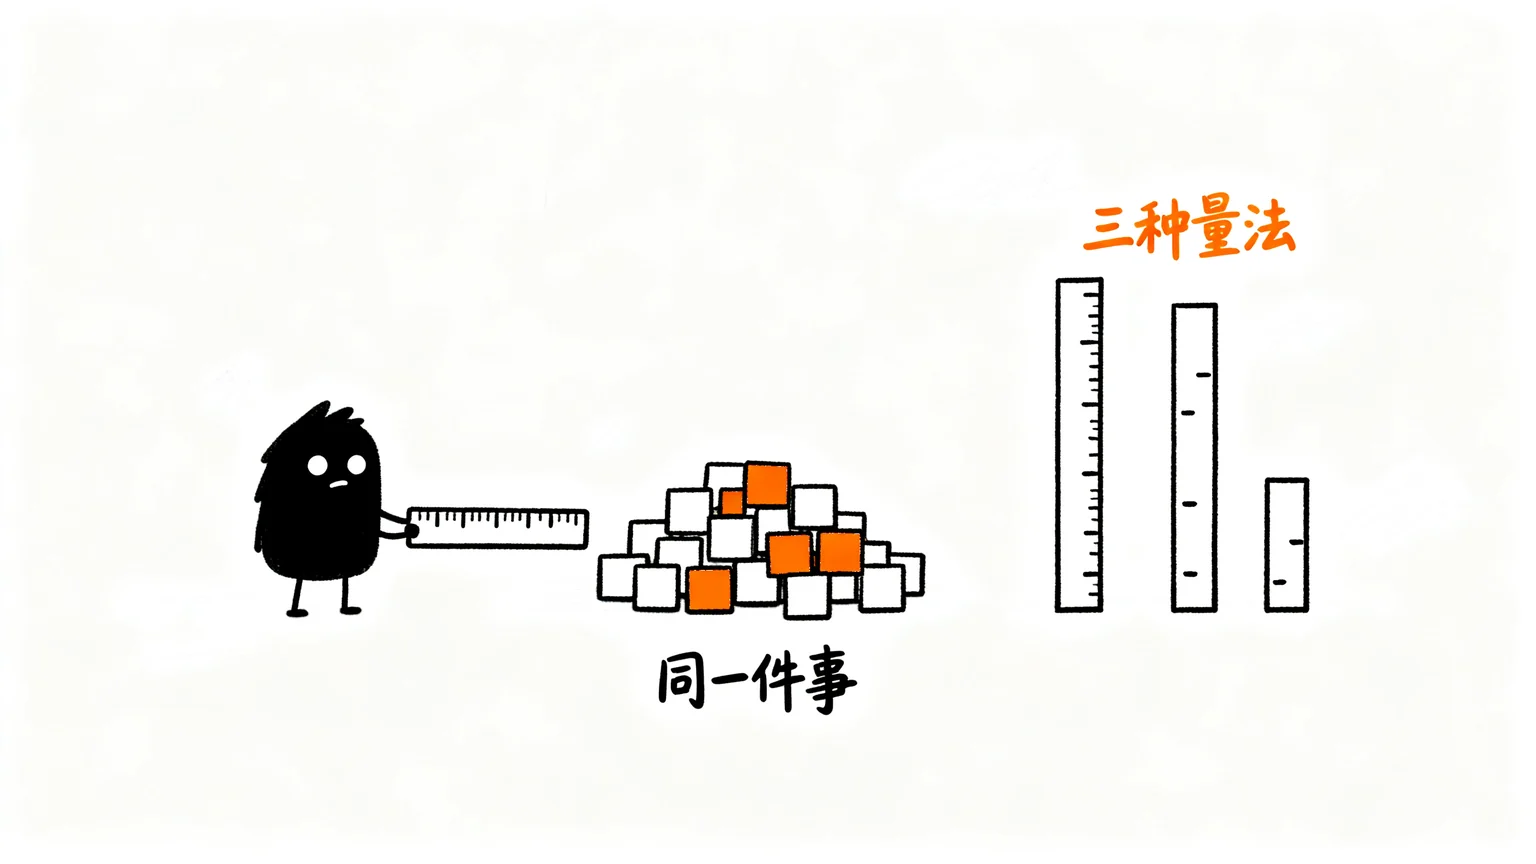 同一堆方块,同一件事,三把尺子量出三个数。问题不在方块,在尺子。
举个最直观的例子。
假设一个 AI 答案引用了 10 个域名,传统搜索的前 10 名也是 10 个域名,其中 2 个是重合的。
同样是这一件事,你可以算出三个完全不同的数:
| 你怎么数 | 结果 |
|---|---|
| 重合的 2 个 ÷ 被引用的 10 个 | 20% |
| 重合的 2 个 ÷ 两堆加起来的 18 个(Jaccard) | 11.1% |
| 有重合的查询 ÷ 全部查询(只要有一个重合就算) | 100% |
三个数字,算术上全对。
但它们说的事完全不同。
- 20% 说的是"我引的书里有多大比例也在前排"
- 11.1% 说的是"两堆书合起来有多少是重叠的"
- 100% 说的是"有多少个问题至少出现过一次重合"
所以,当你看到任何一个人说"AI 引擎的引用重合度只有 X%",第一件事是问他:
你这个 X,分子分母分别是什么?
不写分母就报重合度,是误导。
那前面那一堆数字打架,到底为什么?
有一家做监测的机构把这批研究并排放在一起,找到了两个主要原因:
原因一:单位不同。 有按精确 URL 算的,有按网站/域名算的,有按品牌名算的。同一份数据,换一把尺子,数字就换一个量级。
原因二:算的时候看的是"单个问题"还是"整堆问题"。
这一点特别关键,我用两家机构自己的描述给你看:
- 一家监测机构报告:五引擎的引用,在页面级只有 6.8% 重合,网站级却有 79.6% 的网站只出现在一个引擎上,品牌级是 30.3%
- 另一家机构做的是域名级统计,明确写着:如果用精确 URL 匹配,得到的分数会更低
看出来了吗——"页面级 6.8%"和"品牌级 30.3%"是同一份数据、同一批问题。
它们不矛盾,它们量的是不同的东西。
那为什么有的研究能算出 58%、88% 这么高?
因为它是先把六个月的引用全倒进一个大池子,再取交集——只要一个域名在任何一个问题的任何一方的名单里出现过,就算"共享"。
而低值,是按单个问题逐个对的。
一个问"这一题我们答得一样吗",一个问"我们俩的书架上有没有同一本书"。
两个问题都对,但不是同一个问题。
所以这一节的结论是反直觉的,但很重要:
不要用任何一个"重合度"数字去做决策。 先看它是怎么数出来的。
这句话,是这一整篇里你最该记住的一句。
(顺便交代一下我的取舍:上面那些数字,我只挑了两组能追到原始研究的用——一组是覆盖 2,270 万条引用、115 万个问题的跨引擎重合度研究,一组是它的独立复核。源头查不到出处的,我全部没用。)
那对你来说,先打哪一个
讲到这儿,最自然的问题是:
六个平台,我总不能全做吧?
对,不能。而且你也不需要。
给你四个判断标准,你可以直接拿去用:
第一,看你的客户在哪儿。
他们平时用哪个 AI?是手机上的豆包,还是微信里的元宝,还是电脑上开 ChatGPT?客户不来,做得再好也是自嗨。
第二,看你的内容已经在哪儿。
如果你本来就长期写公众号——恭喜,你已经在元宝的信源池里了,只是还没被翻到。
如果你本来有个独立站——那你的战场更接近 Bing、Google 那一路。
第三,看你有没有能力在那个平台"进池"。
有自家内容池的四个平台,门槛是你能不能进它家生态。没有自家池子的两个,门槛是外面有多少地方在提你。
这两个门槛,难度不一样,投入方向也不一样。
第四,看哪个平台的答案,是你能影响的那批页面决定的。
这是最实用的一条。
你在上一章已经有了一张"信源地图"(第 04 篇的动作)。
现在把那张地图换个平台重新画一遍——你会看到:在哪个平台上,答案是由你能碰到的那批页面决定的。
那个平台,就是你的第一个战场。
不是六个,是一个。
元宝这一节,公众号作者请细看
如果你和我一样,长期在公众号上写东西,那这一节我只说一件事。
回到开头那张表:
| 平台 | 有没有自家内容池 | 池子里是什么 |
|---|---|---|
| 豆包 | 有 | 头条、抖音、快懂百科 |
| 元宝 | 有 | 微信公众号、视频号、腾讯新闻 |
| 文心一言 | 有 | 百度百科、百家号 |
| 通义千问 | 有 | 夸克、淘宝天猫 |
| DeepSeek | 没有 | — |
| Kimi | 没有 | — |
四个有自家内容池的平台里,公众号是唯一一个"个人和企业都能自己生产、而且门槛最低"的池子。
百科要审核,百家号要养,淘宝天猫要开店。
只有公众号——你注册了就能发。
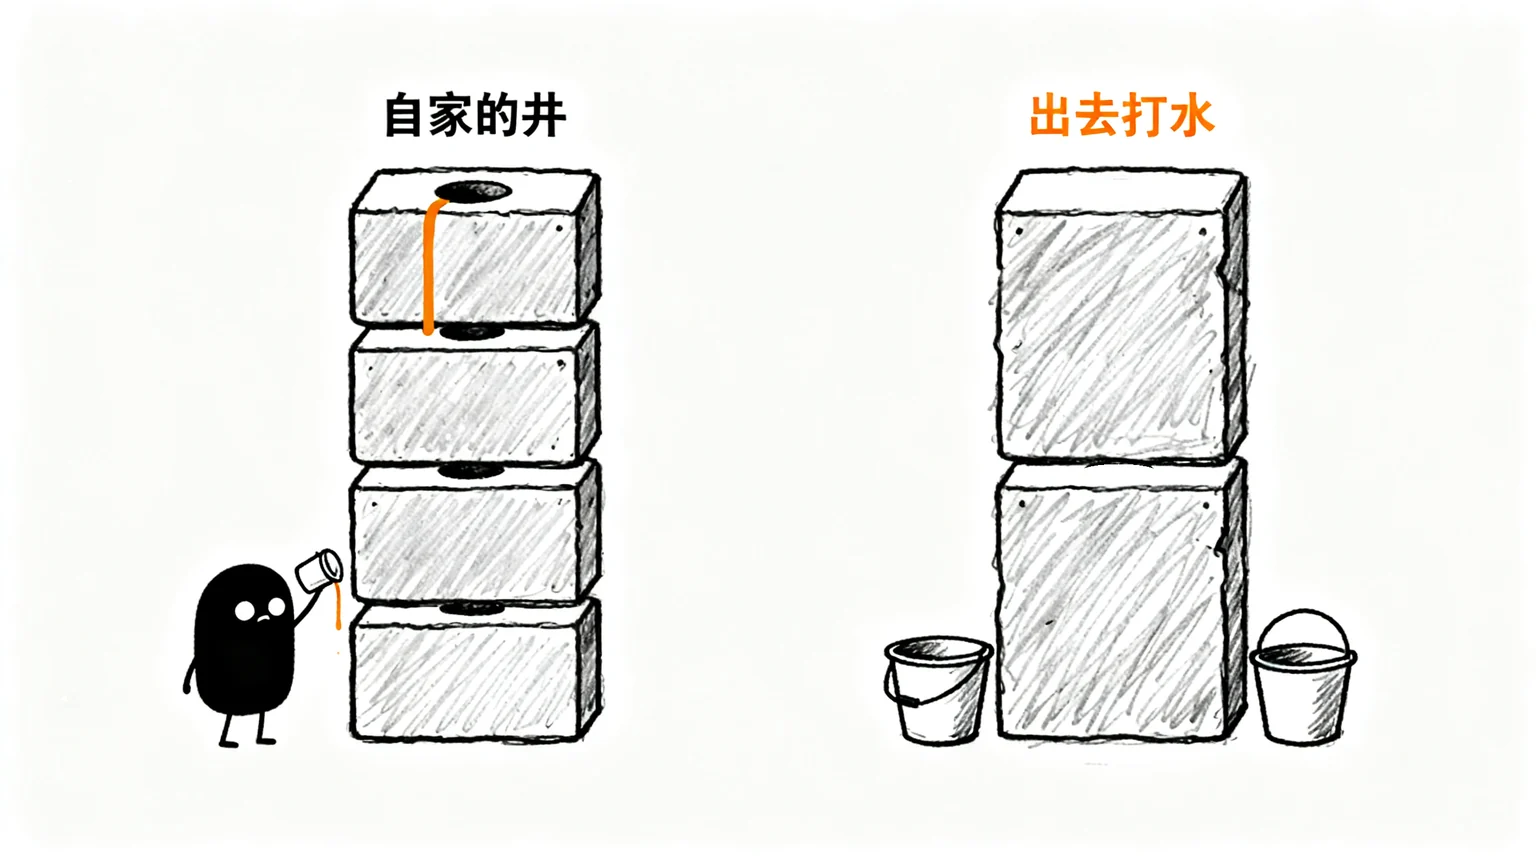 左边四个平台各有一口自家的井,右边两个只能提着桶到处打水。而公众号,是你唯一能自己往里注水的那口井。
腾讯官方那句话说得很清楚:元宝的内容覆盖微信公众号。
这意味着什么?
意味着你每一篇认真写的公众号文章,都天然躺在元宝的信源池里。
不是"要不要去做 GEO",是你已经在池子里了——问题只是它翻没翻到你。
这是绝大多数中小企业做 GEO 时,性价比最高的起点配置。
(具体怎么做,第 09 篇整篇都在讲这件事。)
但这里必须补一句,不然就成鸡汤了。
"在池子里"不等于"会被翻到"。
上一章讲的三道关——翻得到、信得过、摘得走——在元宝这套体系里,要重新算一遍。
你在微信生态里"翻得到",不代表你在豆包那里也翻得到。
这就是这一篇的全部意思:
同样一篇内容,换一个平台,三道关得重新过。
把这一篇的词一次性翻成人话
老规矩,这张表你随时回来查:
| 术语 | 说人话 |
|---|---|
| 信源池 | AI 回答时可能去翻的那一堆页面 |
| 自家内容池 | 平台自己家的内容平台(公众号、头条、百科、百家号……) |
| 查询扇出 / fan-out | 你问一句话,它内部拆成十几个小问题分头搜 |
| 子查询 | 拆出来的那些小问题 |
| 引用重合度 | 两个平台引用的来源,有多少是同一批 |
| 分母 | 你这个比例到底"除以什么"——这是所有数字的前提 |
| 页面级 / 网站级 / 品牌级 | 三种不同的数法:算单个网页、算整个网站、只算名字 |
| Jaccard 相似度 | 一种算法:交集 ÷ 两堆加起来 |
| 稳定性 | 同一个问题重复问,答案里的来源会不会变 |
本节动作
五分钟,做一件事:亲眼看见"口味不同"。
第一步:挑一个你行业里真人会问的问题。
不要带你的品牌名。要像真人在做选择前会问出口的那种。
第二步:把这个一模一样的问题,分别丢给两个平台。
建议选这两个:一个有自家内容池的(比如元宝或豆包),一个没有的(比如 DeepSeek)。
因为这两个的差异最大,对比最明显。
第三步:把两边答案底下的来源,一条一条抄下来,左右两栏并排。
第四步:数三个数:
- 左边有 几条
- 右边有 几条
- 两边重合的有几条
第五步:算一下——重合的那几条,除以"两边加起来一共几条"。
这就是你自己算出来的、有分母的"重合度"。
做完你会拿到什么?
一张两边对照的来源表。
它会告诉你一件很难得的事:
在你的行业里,这两个平台,是从完全不同的地方打听你的。
这就是你的第五份基线。
- 第 01 篇:测「有没有被提到」
- 第 02 篇:测「有没有被说对」
- 第 03 篇:测「是从哪儿被提到的」
- 第 04 篇:测「它翻的书在谁手里」
- 这一篇:测「换一个平台,它的书还在不在那个人手里」
GEO 实验日志 · 第 05 期
先报状态:还是 0。
三个固定问句、六个平台,目前没有一条回答里出现过我。
这一期我不加问句、不加平台。只加一栏。
上一期我加的第五栏是「它引用了谁」——记的是路径。
这一期要补第六栏,因为这一期我学到了一件事:每个平台打听消息的地方不一样。
所以我需要的不是"我有没有被提到",是:
同一个问题,换个平台,它翻的还是不是同一批书。
| 日期 | 平台 | 问句 | 提到我? | 它引用了谁 | ✅ 新增:换平台后来源重合吗 |
|---|---|---|---|---|---|
| — | 元宝 | 问句 A | ○ | — | — |
| — | 豆包 | 问句 A | ○ | — | — |
| — | DeepSeek | 问句 A | ○ | — | — |
| — | 文心 | 问句 A | ○ | — | — |
| — | 通义 | 问句 A | ○ | — | — |
| — | Kimi | 问句 A | ○ | — | — |
还是空的。六个圆圈,三列破折号。
我知道这张表现在看着挺尴尬的。
但我留着它,是因为它回答了一个我一直在躲的问题:
我到底该先做哪个平台?
这一栏填上第一行的时候,就是答案出来的时候。
- 第五栏记的是「它从哪儿拿的料」
- 第六栏记的是「这些料,是不是只有一个平台在用」
如果一个来源只在一个平台出现——那它就是这个平台的专属入口。
找到三个这样的入口,你就知道自己该先打哪儿了。
下一次公布:第 06 篇文末。
写在最后
这一篇只讲了一件事:
同一个问题,六个平台给你六个答案。
拆开看是三层:
- 信源池不一样——四个有自家的井,两个只能出去打水
- 检索方式不一样——你的一句话,它内部拆成十几个小问题分头去搜
- 而你看到的那些数字,量法可能完全不一样——从 6.8% 到 88%,可能全是对的
这三层里,我觉得最值钱的是第三层。
因为前两层,最多让你做错内容;第三层,会让你做错决策。
你拿着一个"重合度只有 11%"的数字,去说服老板把预算摊到六个平台——
但那个 11%,可能只是因为它按域名算、按单个问题算。
换个算法,同一份数据可以是 88%。
今天带走一句话就够了——
别问"AI 引擎之间的重合度有多少"。 先问"你这个数字,分子分母是什么"。
九个数字里,只有一个你能用。前提是你知道它是怎么来的。
觉得有用就点个赞、在看吧,下次被AI概念绕晕的时候回来看看。
这一篇读完,你应该能做到: 说出六个主流 AI 在"有没有自家内容池"上的分野,讲清"查询扇出"为什么会让答案每次都不一样,并在看到一个"重合度"数字时先问它的分母是什么。
下一篇预告: 第 2 阶 · 第 6 篇《为了搞懂 GEO,我把中文互联网搜了一遍,全是软文》——这一篇里我反复说"这个数字我没用""那个我没用",下一篇就把原因摊开:同一个市场,市场规模有五个互相差十倍的数字,而且每一个都追不到源头。这是整个系列里最该看的一篇。