GEO 实战笔记 / 04
AI 不是在"记得"你,它是在"找"你
一位做工业配件的老板跟我说,他官网做得够细了,产品页三千多字、参数认证案例全在上面,"AI 肯定能读到吧"。我让他问 AI 一句行业问题,看答案底下那几条来源——五条里没有一条是他自己的网站。这一篇把 AI 的黑盒拆开一层:它不是"知道"你,是每次都在现场去查你。而一次 AI 回答的背后有三道关——翻得到、信
本篇目录
我是醒醒,AI共学社主理人,30岁程序员转型一人公司践行者。闲鱼+小红书变现五位数,已帮500+人用AI为工作提效。不教你追工具,只帮你用AI解决问题、赋能业务。长期主义者,专注让AI真正落地到你的工作里。
GEO 实战笔记 · 第 04 篇 你现在在哪:第 2 阶 · 看懂 这一篇带你去哪:弄明白 AI 到底是怎么挑内容的,知道劲儿该往哪儿使
上周一个做工业配件的老板加我微信,第一句话是:
「我官网做得应该算细了,产品页三千多字,参数、认证、案例全堆在上面。AI 肯定能读到吧?」
我没回答,让他先做一件事:
打开 AI,问一句「XX 配件哪家做得好」,然后低头看答案底下那几行来源。
十分钟后他回来了,语气有点闷:
「一条都不是我的。」
五条来源里,两条是竞品的页面,一条是行业媒体,还有一条——他说他压根没听过那家公司。
这不是个例。
这是绝大多数企业第一次做 AI 体检时的标准反应。
而且它背后不是"你内容写得不够好"这么简单。
今天这一篇,我把这个黑盒拆开一层。
先破一个误解:AI 不是"知道"你,是"现场去查"你
大多数人脑子里的 AI,是个背过书的考生。
以为它读过一遍互联网,把你的信息"记住"了,然后你一问,它从记忆里翻出来回答你。
不是。
它更像个开卷考试的考生——只带了一个检索框进考场,答案是从它当时能翻到的书里,现摘的。
这不是我猜的。
GEO 这一行最重要的那篇论文(Princeton 和 IIT 德里做的,KDD 2024 发表),把这类系统叫"生成式引擎",给的机制定义就是两步:
先去检索一批相关资料,再让模型依据这些资料,写出答案。
论文里那个实验引擎的做法很直接:拿 Google 排前 5 的页面当资料,然后据此生成回答。
所以"AI 提到我"这件事,本质不是一次记忆,是一次现场检索的结果。
而"现场"这两个字,藏着一个很多人没意识到的事实——
它每次翻到的书,可能不一样。
有个覆盖百万级 AI 回答的观测研究,测出来一个比例很扎眼:
ChatGPT 一次检索的页面数量,大约是它最终引用的 6 倍。 被它翻到的页面里,85% 一条引用都没拿到。
翻六本,只用一本。
这才是"AI 提到你"的真实竞争强度——不是"你够不够好",是"你在它翻到的那几本里排第几"。
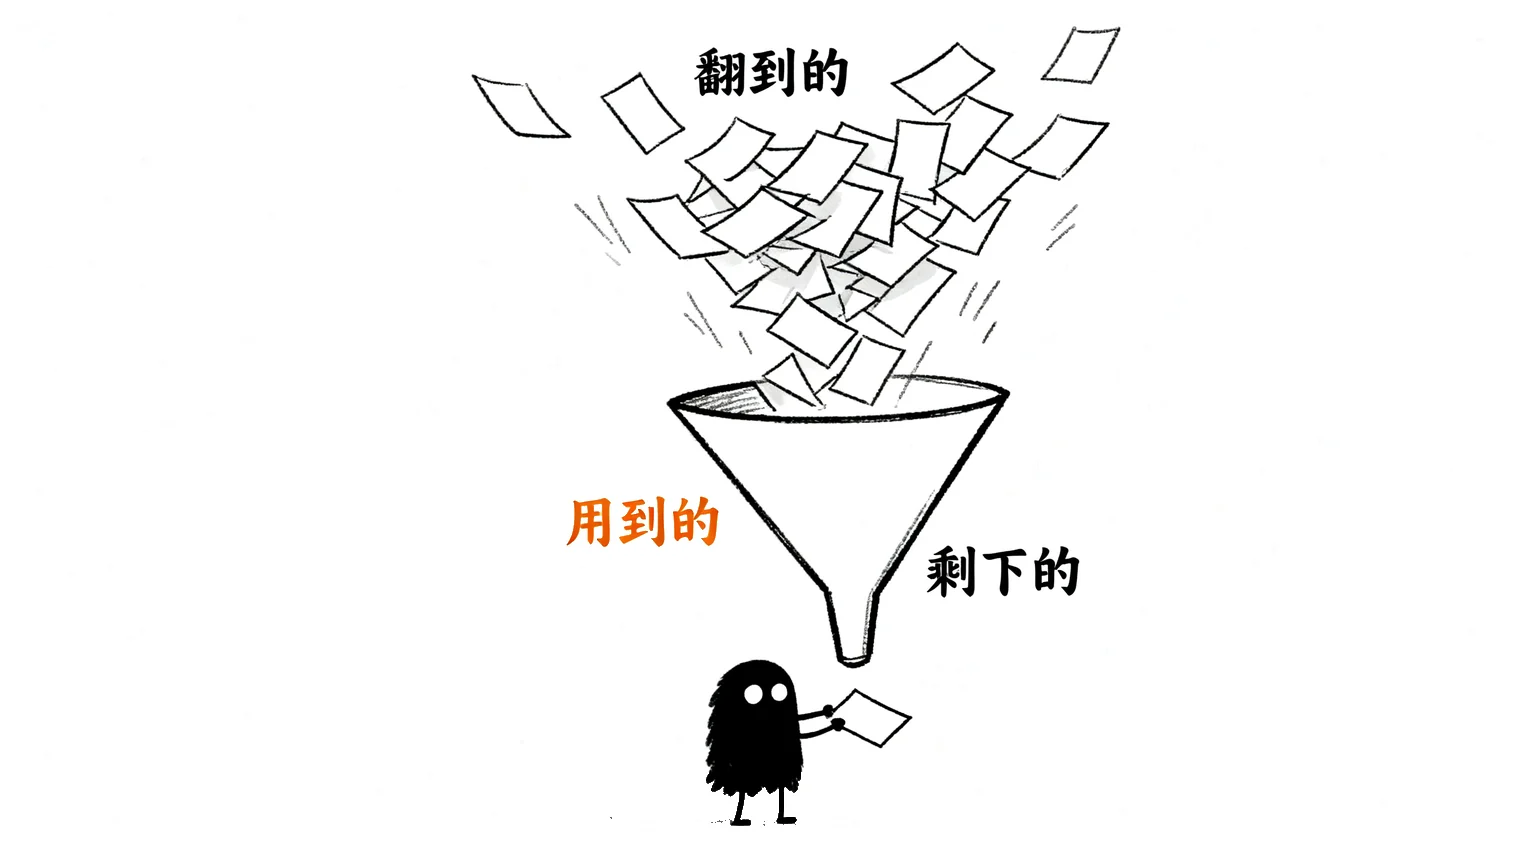 上面倒进去的,是它翻到的一大堆;下面漏出来的,只有一张。被翻到,和被用上,中间隔着五次漏斗。
这里要停一下,说清一件容易混的事。
上上篇(第 02 篇)我讲过三个动作:被提到 → 被引用 → 被说对。
那三个动作,是你已经进了答案之后的分级。
这一篇讲的,是它之前的事——你连答案都还没进去。
因为在那之前,还有一道更早的漏斗。
它挑内容,看的是三道关
一个页面想从"被翻到"走到"被用上",要过三道关。
| 关卡 | 行话怎么说 | 说人话 |
|---|---|---|
| 第一关 · 翻得到 | 可抓取、可索引、在信源池里 | 你的书在不在图书馆架子上,门开没开 |
| 第二关 · 信得过 | 权威度、多源印证 | 有没有别人也这么说 |
| 第三关 · 摘得走 | 结构化、可摘录性 | 能不能整段撕下来直接用 |
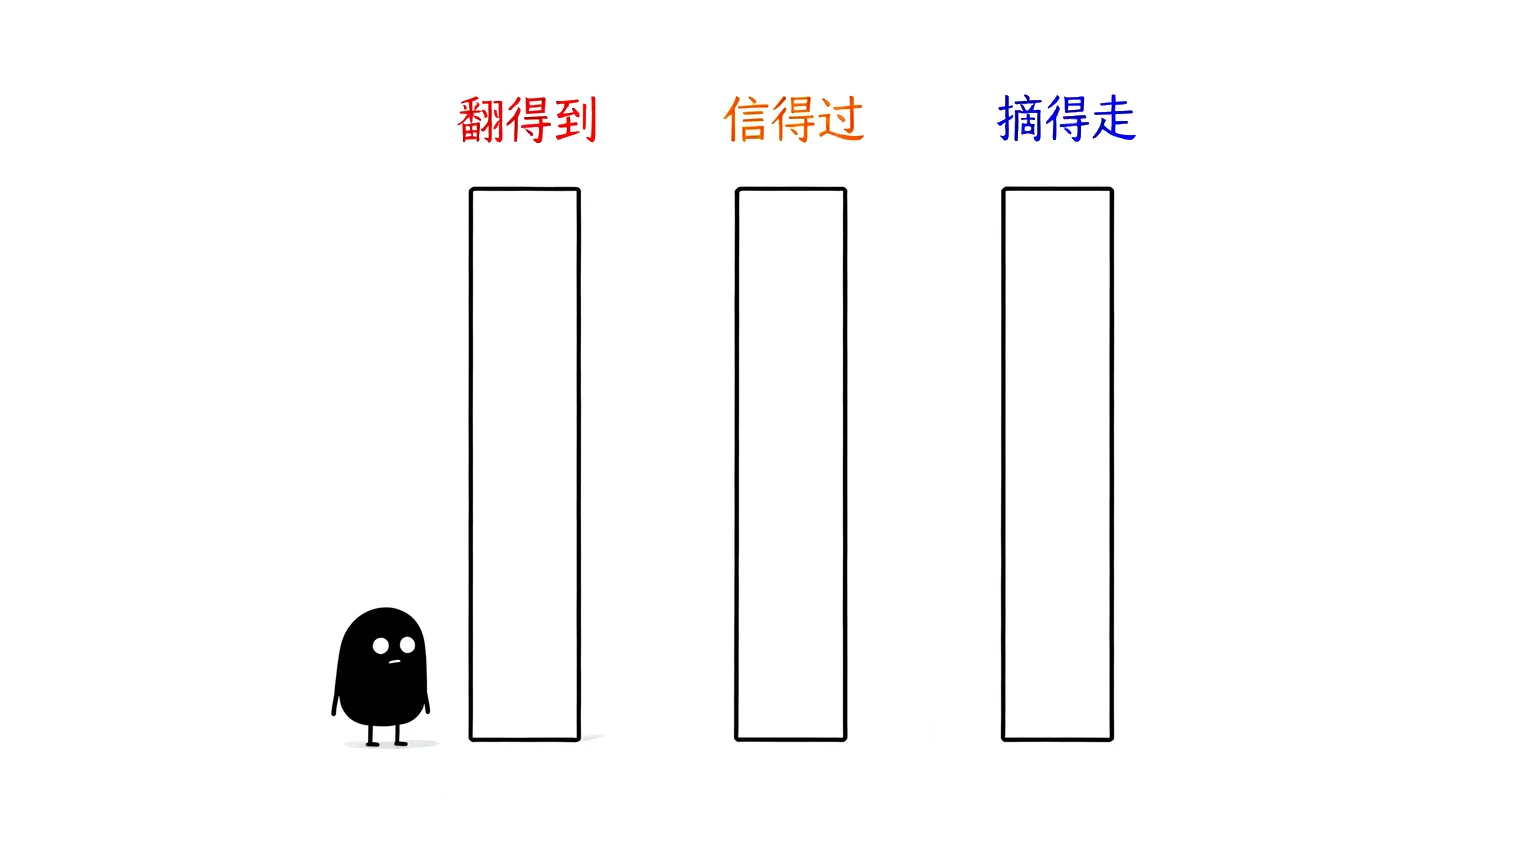 三道关竖在那儿。它不会替你难过——过不去就是过不去,答案里没有你就是没有你。
三道关的失败,原因完全不同。
所以对策也完全不同。
下面三节,一关一关说。
第一关:门被关上了,你自己还不知道
这一关最扎心的地方在于:大部分人的问题,根本不是内容不行。
是压根没被读到。
想弄明白这件事,先要知道 AI 的爬虫其实分三类(下面这张表,是我建议你存下来的一张):
| 类别 | 干什么用 | 代表 |
|---|---|---|
| 训练爬虫 | 内容拿去喂模型,影响"模型本身对你的印象" | GPTBot、ClaudeBot、Google-Extended、CCBot |
| 检索爬虫 | 让 AI 回答时能把你当来源,影响"答案里有没有你" | OAI-SearchBot、PerplexityBot、Claude-SearchBot、Googlebot |
| 用户触发爬虫 | AI 正在读你这一页(有人让它看了) | ChatGPT-User、Claude-User |
为什么这个区分特别重要?
因为它们俩常被一起屏蔽。
很多站长为了"不让我的内容被白拿去训练",在后台点了"屏蔽 AI 爬虫"。
结果把检索爬虫一起关了——等于主动从答案里退赛。
而这在 2026 年已经成了默认值,不是个别现象:
- Cloudflare 从 2025 年 7 月 1 日起,新接入的域名默认屏蔽 AI 训练爬虫,而且是网络层强制的,不看你 robots.txt 里写了什么
- 一份 2026 年 8 月的公开普查(按 Tranco 榜单前 100 万名加权)显示:约 14% 的站点在 robots.txt 里完全屏蔽了 GPTBot;屏蔽训练类爬虫的站点比例(15.9%)是屏蔽检索类(7.6%)的两倍
一半以上的人,关错了门。
更隐蔽的还有一层。
robots.txt 只是一份"请求",不是"执行"。
你可以让它写着"欢迎 GPTBot 光临",但如果你站前面挡着一道 CDN 或者防火墙,它照样进不来,而且你不会收到任何通知。
同一份数据里还有个对照:
大站里真正在 robots.txt 里写死屏蔽 GPTBot 的,只有约 11.7%。 但 Cloudflare 网络上,AI 爬虫的请求只有 63.7% 能正常拿到 200 —— 14.6% 被挡回 403,还有 2.6% 被限流。
两个数字说的不是同一件事。
而它们之间的那条缝,就是大多数"我明明内容很好,为什么 AI 不提我"的答案。
最后补一刀,这是本篇最该记住的一条:
Googlebot 属于"检索爬虫"这一类。 什么概念?你屏蔽了它,AI 概览那块地方,你连候选资格都没有。
第一关不是积分赛,是资格赛。
过不了,后面两关根本没机会考。
(怎么一项一项查出来?这是第 13 篇的活儿,会把清单直接给你。)
第二关:它更信"别人口中"的你
假设你的门开着,它翻到你了。
接下来它要判断:敢不敢用你。
这里藏着整篇最反直觉的一个数字。
有个研究盯了 102 个品牌、102,025 条 AI 回答、149,912 条引用,跨五个引擎,看这些引用到底指向哪儿。
结论是:
只有 2.9% 的引用,指向品牌自己的域名。 75.2% 指向的是企业页和竞品页——就是那种你自己没有登录权限、改不了一个字的页面。
换句话说:
97% 的"依据",不在你自己手里。
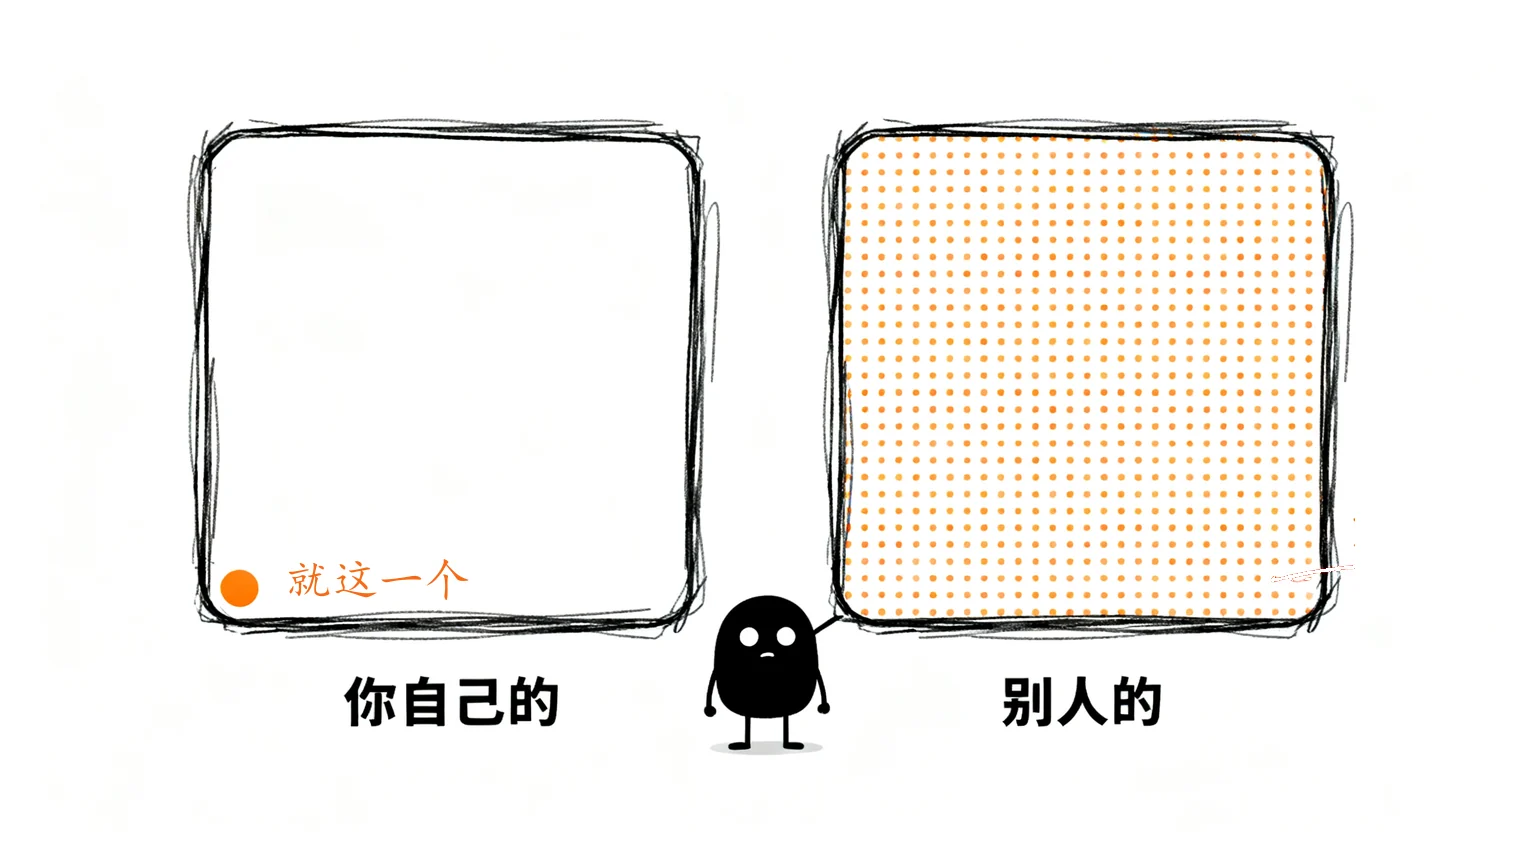 左边是你自己的网站,几乎整片是暗的。右边是别人的页面,密密麻麻全是亮的。
剩下的那部分非企业来源,排在前面的是:视频(约 4.2%)、科技与商业媒体(约 3.8%)、Reddit 这类社区(约 3.3%)、维基百科(约 2.6%)、G2 和 Capterra 这类评测站(约 1.1%)。
看出重点了吗?
视频、媒体、社区、评测站——全是你自己网站上没有的东西。
打个比方。
你去应聘,简历上写"我特别专业"。
没人在乎。
但如果三个前同事在外面说"这人专业",招聘方立刻就信了。
AI 就是那个一定会去背调的 HR。
如果你只把官网做得漂漂亮亮,等于只在一个 3% 的战场上使劲。
那 97% 的地方,你一次都没去过。
这也解释了另一半:为什么"一致性"比"华丽"更重要。
同一件事,如果三个不同的地方说法一样,AI 敢用。
只有一个地方说过,还是你自己说的——它多半不用。
孤证不采信。
这一节我必须在最后补一段。
上面那组数据来自一份 2026 年 6 月上传的研究,它的作者,正好就是做 AI 可见度监测的那个商业平台的运营者。它是一个单一作者、只在预印本平台公开、未经同行评审的研究,样本也偏 SaaS 和零售执行类品牌。
所以那 2.9%、75.2%,不能当成人口普查数字来用。
但它的方向——"绝大多数 AI 引用来自第三方,而不是品牌自己"——和别的研究是对得上的。
方向拿来用,比例记个大概。这就是看数据的正确姿势。
(顺便,这也是第 02 篇那句"大公司更容易被提到、小主体更容易被引用"的另一面。)
第三关:好不好被"整段撕走"
门开了,它翻到你了,也信你了。
最后一步:它要把一段话拿走,放进答案里。
这一步的机制,很多人想错了。
它不是"读完整篇文章再自己总结"。它是摘句子。
所以,你哪一句话能被整个撕下来直接当答案,你就有机会。
有一项观测研究专门去测"它到底从文章的哪个位置撕":
- 44.2% 的引用,来自一篇文章前 30% 的内容;中段(30%-70%)占 31.1%,最后一段只有 24.7%,越靠近文末越陡降
- 放到段落层面,53% 的引用来自段落的中间——不是第一句,也不是最后一句
第二条特别值得琢磨。
意思是:光有一句漂亮的开场白没用。那一段本身得有干货。
再看它偏爱什么样的句子:
- 使用"下定义"式表达的句子("X 是……"这种),被引用的概率约是普通句子的 2 倍
- 含问号的段落,被引用的概率也约是 2 倍。而且——78.4% 跟问题相关的引用,来自"一个标题 + 紧跟着的那段回答"
78.4% 这句话,是这一整节最值钱的一句。
翻译过来就是:
AI 会把你的小标题,当成用户在问的问题。 然后把紧跟在小标题下面的那段话,当成答案。
所以,如果你的小标题写的是《行业现状分析》,下面第一段还在铺垫背景……
那正好,在两个都不会被摘的位置上,各放了一段不会被摘的话。
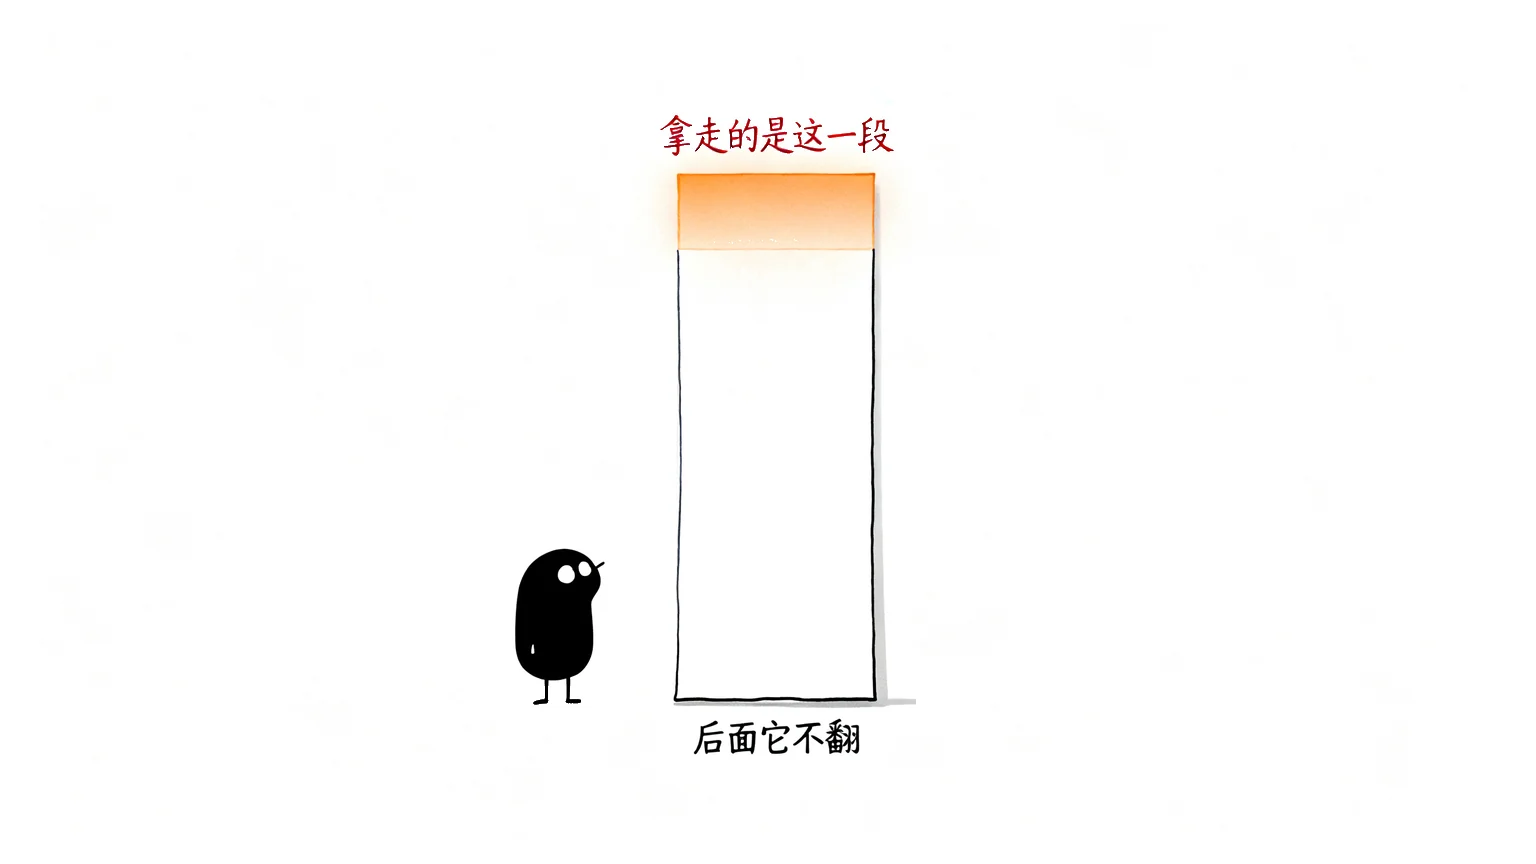 被点亮的只有最上面那一小段。剩下的再厚,它也不翻到底。
还有一条也很有意思:被大量引用的内容里,专有名词的密度是 20.6%,而普通英文语料只有 5%-8%。
说人话:少说"很多企业""各种工具",多说具体的名字。
有名字、有数字、有出处的句子,它才敢摘。
翻成三条可以直接上手的写法:
| 别这么写 | 这么写 |
|---|---|
| 用一个漂亮的开场白铺垫半天 | 把最重要那句放在最前面 |
| 小标题写《行业现状分析》 | 小标题直接写成用户会问的那句话,下面第一段就把答案说完 |
| "很多企业已经开始做" | "某机构 X 月的数据显示……" |
具体的五个动作,是第 08 篇的活。这一篇只负责让你明白:为什么这么写更容易被摘。
(说明:这一节的数字来自第三方分析师的观测研究,由媒体转载报道。它是相关性观测,不是因果实验——具体比例会随平台和时间变,别把它当固定参数。)
最后一张表,可能有点扎心
讲到这里,我得把最难听的那组数字也摆出来。
同一份研究还测了一件事:在不带你品牌名的问句下(也就是"XX 行业哪家好"这种真正的战场上),不同体量的品牌,第一次被提到的概率:
| 品牌体量 | 首轮被提到的概率 |
|---|---|
| 最大的一批(11 个) | 72.9% |
| 中型(36 个) | 43.6% |
| 最小的那批(55 个) | 11.4% |
每一级差大约 30 个百分点。
看到这儿的第一个反应,大概是:那还做什么,小品牌没机会了。
先别下这个结论。有三件事必须说清楚。
第一,这是"起点",不是"终点"。
它测的是第一次被提到的概率。而它之所以存在,恰恰是因为那些大品牌已经有太多地方提过它们了——不是它们的技术比你好。
第二,这个分层是按维基条目、媒体报道、融资情况人工编出来的。
说白了,它量的是"网上有多少地方提过你"这件事,不是天生属性。
第三,也是最关键的:那 97% 的引用来自第三方。
第三方,是可以一个一个铺出来的。
你不能让 AI 突然"认识"你,但你能让第五个、第十个地方开始提你。
大品牌的 30 分优势,不是技术优势,是时间优势。
所以小主体现在最该做的,不是羡慕那个 73%。 是先去数一数:今天,外面有几个地方提过你。
数完那个数字,比看这张表有用得多。
最后,把这一篇出现的词一次性翻成人话。这张表你随时回来查:
| 术语 | 说人话 |
|---|---|
| 信源池 | AI 回答时,可能去翻的那一堆页面 |
| 可抓取 | 爬虫能不能进到你的页面 |
| 可索引 | 进来了,有没有被收进"可查的名单" |
| 训练爬虫 | 把你的内容拿去喂模型,管"它认不认得你" |
| 检索爬虫 | 让它回答时能引用你,管"答案里有没有你" |
| 多源印证 | 同一件事有好几个地方都说过 |
| 可摘录性 | 你那一段能不能被整个撕下来用 |
本节动作
现在轮到你动手。
这个动作我特别推荐,因为做完你会拿到一张清单——不是感受,是待办。
第一步:挑一个你行业里真人会问的问题。
不要带你的品牌名。要像一个真人在做决定前会问出口的那种。
比如:「XX 行业哪家做得比较靠谱」「XX 该怎么选才不踩坑」。
第二步:把这个问题丢给 AI,然后看它的来源。
大多数 AI 回答的下面或者句子里,会带可点开的小标签——那些就是它翻的书。
把它们一条一条抄下来。
第三步:分三栏。
- 我自己的——我的网站 / 我的公众号 / 我的其他页面
- 同行的——竞品、同行、同区域的对手
- 第三方的——行业媒体、社区论坛、评测站、视频、百科……
第四步:回到第三栏,问一句:
「这些都是第三方。那哪些,是我现在就能去出现的?」
五分钟。
做完你手里就有了两样东西:
一张地图(现在 AI 是从哪儿打听你的行业的),
和一张待办清单(我该去哪些地方出现)。
注意——它不是"我要做 GEO"这种空话,它是几个具体的地点。
截图存好,这是你的第四份基线。
- 第 01 篇:测「有没有被提到」
- 第 02 篇:测「有没有被说对」
- 第 03 篇:测「是从哪儿被提到的」
- 这一篇:测「它翻的书在谁手里」
四份凑齐,你就不只是知道规则了——你知道该往哪儿站。
GEO 实验日志 · 第 04 期
先报状态:还是 0。
三个固定问句、六个平台,目前没有一条回答里出现过我。
这一期不加新问句,不加新平台。
只加一栏。
上一期(第 03 期)我定的是"怎么捕捉第一次被提到"。这一期要补的是——捕捉到之后,看什么。
因为这一期我学到了一个数字:97% 的引用来自第三方。
所以这一栏的价值,比前面四栏加起来还高:
| 日期 | 平台 | 问句 | 提到我? | ✅ 新增:它引用了谁 |
|---|---|---|---|---|
| — | 豆包 | 问句 A | ○ | — |
| — | 元宝 | 问句 A | ○ | — |
| — | DeepSeek | 问句 A | ○ | — |
| — | 文心 | 问句 A | ○ | — |
| — | 通义 | 问句 A | ○ | — |
| — | Kimi | 问句 A | ○ | — |
是空的。全部是空的。
我知道这张空表看起来有点可笑——六个圆圈,加上一列破折号。
但它是我这一期唯一想做的事,理由很直白:
这一栏只要填上第一行,我就拿到了一个"我该去哪儿"的具体地址。 而这一栏是空的,我就永远只能停留在"我要做 GEO"这种废话上。
第一栏记"我有没有被提到",是记结果。 第五栏记"它引用了谁",是记路径。
结果要靠运气的成分,路径不用。
下一次公布:第 05 篇文末。
写在最后
这一篇讲了一个动作:把 AI 的黑盒拆开一层。
拆完之后,它长这样:
它不是"知道"你。它是每次都在现场去查你。
而它查的时候,要过三道关:
- 翻得到吗——你的门开着吗
- 信得过吗——有没有别人也这么说
- 摘得走吗——你能不能整段被拿走
三道关,三道完全不同的问题。
如果你看完有点不舒服——那是好事。
不舒服说明你意识到:你过去所有的力气,可能都花在了第三关上,而第一关的门是关着的。
这不是你的错。没人告诉过你这三道关的存在。
但有一件事得你自己做:先去看门。
今天带走一句话就够了——
AI 不是在"记得"你,它是在"找"你。 你要做的不是喊得更响,是让它更容易找到、更愿意相信、更方便引用。
觉得有用就点个赞、在看吧,下次被AI概念绕晕的时候回来看看。
这一篇读完,你应该能做到: 说出 AI 挑内容要过的三道关,讲清"训练爬虫"和"检索爬虫"的区别,并用一张"信源地图"看出自己现在卡在哪一关。
下一篇预告: 第 2 阶 · 第 5 篇《六个平台口味完全不同,一套内容打不了天下》——为什么同一个问题,问不同的 AI 会得到完全不同的答案;以及那张可以直接存下来的「六大平台信源偏好对照表」。