GEO 实战笔记 / 06
为了搞懂 GEO,我把中文互联网搜了一遍,全是软文
我准备写这个系列之前,先把「GEO」这个词从头到尾搜了一遍——搜完发现一条数据都用不了。同一件事实,市场规模有八个互相矛盾的版本,最大的和最小的差两百倍;同一个数字被挂到两个不同机构名下;同一个机构的同一个指标,两家稿子说得完全不一样。更荒诞的是:这批稿子本身就是 GEO 操作——它们在批量生产内容、试图让
本篇目录
我是醒醒,AI共学社主理人,30岁程序员转型一人公司践行者。闲鱼+小红书变现五位数,已帮500+人用AI为工作提效。不教你追工具,只帮你用AI解决问题、赋能业务。长期主义者,专注让AI真正落地到你的工作里。
GEO 实战笔记 · 第 06 篇 你现在在哪:第 2 阶 · 看懂(收尾) 这一篇带你去哪:学会分辨一个数字能不能用,并且知道为什么这个系列的数据值得你信
我准备写这个系列之前,先做了一件事:做功课。
我把「GEO」这个词,从头到尾搜了一遍。
从最常见的搜索词,一直搜到行业的边角。
搜完,我坐在那儿愣了一会儿。
因为我发现——我一条数据都用不了。
不是没有数据。
是数据太多了,而且互相打架。
这一篇,就是那天的结论。
先说结论:这个领域,本身就是一个 GEO 现场
先讲一句可能有点绕的话。但你只要记住它,这一篇就没白读:
做 GEO 的人,正在用 GEO 的方式,污染 GEO 的信息。
什么意思?
GEO 的核心动作,是批量生产内容,让 AI 学到你。
而围绕「GEO」这个词的中文内容,压倒性地就是被这么生产出来的——批量、同质、互相抄、追不到源头。
于是出现了一个非常荒诞的闭环:
你为了搞懂 GEO,去问 AI「GEO 是什么」。
AI 教给你的,正是这批做 GEO 的稿子。
这不是我猜的。这一篇我会把证据一条一条摆出来。
三条,从轻到重:
- 同一件事实,我搜出了八个数字——最大的和最小的差两百倍
- 这批稿子的三个特征,指向同一个机制——而其中最有力的一条证据,是它们自己写下的
- 连一篇可以直接查到原文的学术论文,经过转述都会变形——能查原文的都这样,那追不到源头的呢
先说个离你最近的。
同一件事,我搜出了八个数字
上一篇我留了个话头。
我说,网上流传的六平台信源偏好数字——「元宝 65% 来自微信生态」「文心一言对百度系引用率 81.7%」这一类——我一个都没用。
原因下一篇讲。
现在讲。
但讲之前,我得先给你看更狠的。
因为那批数字不是孤例。我搜了一圈,发现整个 GEO 领域的数据,几乎全是这个状态。
举个最直观的例子:中国的 GEO 市场,到底多大?
我一次检索,拿到了八个版本:
| 转述里挂在谁名下 | 说的哪一年 | 数字 |
|---|---|---|
| 易观分析 | 2025("GEO 元年") | 2.5 亿元 |
| 艾瑞咨询 | 2025 | 6 亿元 |
| 艾瑞咨询 | 2025 | 127 亿元 |
| 易观分析 | 2026 | 30 亿元 |
| 某篇转载稿 | 2026 | 40—60 亿元 |
| 中国信通院 | 2026 | 286 亿元 |
| 易观分析 | 2026 上半年 | 500 亿元 |
| IDC | 2026(全球市场) | 220 亿美元 |
前面七个数,说的是同一件事——中国市场。
最大的是最小的两百倍。
第八个说的是全球,跟前面七个根本不是一回事。也就是说,这八个数连"量级"都没对齐。
但比数字本身更说明问题的,是下面三件事。
第一件:同一个数字,挂到了两个机构名下。
「286 亿」这个数,在一篇稿子里写的是艾瑞咨询的数据;在另一篇里写的是中国信通院的数据。
同一个 286 亿,两个东家。
第二件:同一个机构、同一年份,两个数。
「艾瑞咨询 2025 年」:一篇稿子写 127 亿,另一篇写 6 亿。
差 21 倍。
第三件:同一个机构的同一个指标,两家稿子说得完全不一样。
「中国信通院的企业端渗透率」——一篇写「从 2025 年的 38% 跃升到 71%」;另一篇写「从 2025 年的 12.3% 升到 38%」。
注意,第二个版本里的那个 38%,正好是第一个版本的起点。
同一份报告,一家读出来是"38% 到 71%",另一家读出来是"12.3% 到 38%"。
同一份报告,读出两个完全不同的故事。
再补一句最要命的:
这八个数里,没有一条写清楚了样本量、统计口径、时间窗口。
也没有一条能点到原始报告。
 同一件事,八个版本。这不是数据,这是七个回声。
我为什么犹豫?因为我没法判断哪个是对的——而且我怀疑它们谁都没见过原始报告。
到这儿你可能想:那我不看这些稿子,直接去看服务商官网不就行了?
不行。因为问题比"数据假"更深一层。
四篇稿子,一个模子
我把搜出来的那几篇摆在一起看,发现了三个共同特征。
特征一:它们互相抄数字。
刚才那三处"对不上"就是证据。如果每篇都老老实实引原始报告,286 亿就不会有两个东家,艾瑞 2025 年也不会既是 127 亿又是 6 亿。
对不上,是因为中间经了手。
特征二:它们互相排座次。
这个更有意思。
我搜出来的每一篇「行业观察」「深度解析」「白皮书发布」,都会"顺便"评出几个标杆服务商:
| 稿件类型 | 被排进"标杆 / 领先"的公司 |
|---|---|
| 某行业白皮书发布稿 | 传声港、传新社、怪兽智能 |
| 某市场格局深度解析 | 百分点科技 |
| 某标准发布稿 | 小易智联 |
| 某服务商综合观察 | 实朴科技 |
每一篇的"前三名"都不一样。
而且还有个更微妙的共同点:每一篇里,被点名的公司都恰好是那篇稿子里唯一有名有姓的公司。
一篇讲"行业格局"的文章,通篇不谈方法、不谈数据、不谈局限,只谈"谁最强",而且答案就是发稿的那家。
这不叫行业观察。这叫排座次。
(我不打算给哪家公司扣帽子——我根本没能力判断它们各自做得怎么样。我在这里只指出一件事:每一篇给出的名单都不一样。 光这一条,就说明它们不是观察出来的。)
特征三——也是最要命的一条:这些稿子自己,就是 GEO 操作。
前面我说过,GEO 的核心动作是「批量生产内容,让 AI 学到你」。
那你回头看看这几篇稿子是什么:
- 它们批量生产
- 它们同质——同一个模子、同一批数字、同样的座次
- 它们的目的是让 AI 检索到它们、引用它们
它们在做的,就是 GEO。
而它们要让人学到的东西里,就包括那八个互相矛盾的市场规模数字。
所以你现在去问任何一个 AI「GEO 市场规模多大」,它给你的,大概率就是上面表里的某一个。
而且大概率不带出处,或者带一个你也查不到的出处。
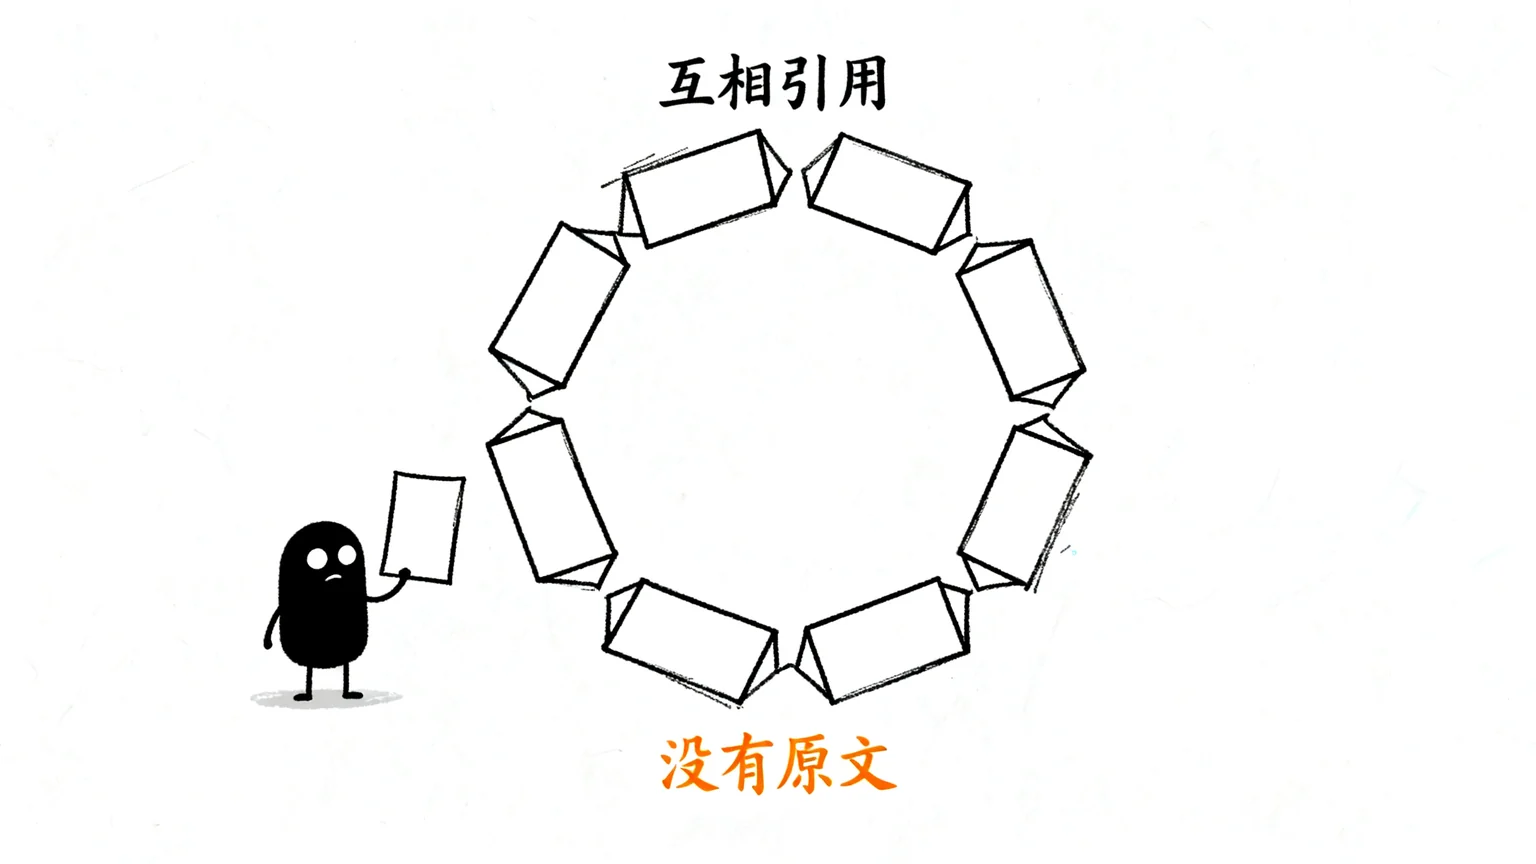 你引我,我引他,他引你。圈里全是回声,没有一个人手里有原文。
(这里我得说清楚:我没有办法在这里替你问。 你可以自己去试——问完看它给的数字,在不在上面那张表里。如果在,而且没出处,那你就亲眼看到这个闭环了。)
但我不想只讲到"它们坏"。
因为更让我在意的是——这个循环里,可能根本没有几个人是故意的。
下面这个故事,是这个系列里我最想让你看的一段。
连能查到原文的论文,都会被转述变形
我要给你看一个你自己就能核的例子。
GEO 这个领域,有一篇公认的奠基论文:《GEO: Generative Engine Optimization》。2023 年 11 月发在 arXiv,被 KDD 2024 收录。作者来自普林斯顿、佐治亚理工、IIT 德里、艾伦人工智能研究所。
它的原文,谁都能点开看。
论文测了九种内容优化方法。其中有一种叫「关键词堆砌」——就是以前做 SEO 的老办法,往页面里硬塞关键词。
中文互联网上,你几乎一定见过这句话:
「关键词堆砌在 GEO 中反而有害,会让可见性下降 8.3%。」
我见过很多次。我一开始也信。
直到我去读了原文。
论文里关于关键词堆砌,原话只有这一句:
we find such methods have little to no performance improvement on Generative Engine's responses. (我们发现这类方法对生成式引擎的回答几乎没有性能提升。)
"几乎没有提升"。
不是"有害"。
论文的表格里,关键词堆砌的客观得分是 17.8,无优化基线是 19.5——它确实排九种方法里的最后一名,也是唯一一个低于基线的。
按这个算下来,是 -8.7%。
但论文没有做显著性检验,也没给 p 值。
也就是说,论文自己的态度是:"我们观察到的这点差异,还不足以构成一个结论。"
那中文互联网上的「下降 8.3%」是怎么来的?
我顺着查了一圈,至少三个版本:
- 有的写 -8%,还配了一句警示:"传统 SEO 策略反而有害"
- 有的写 -8.3%
- 还有的写 -10%,直接说"会导致可见性下降 10%"
三个数字,一个比一个语气确定。
而论文原文,是这三个数字里最不确定的那个。
回头再看一遍这条链:
- 论文说:几乎没有提升(并且没做显著性检验)
- 第一层转述说:下降 8.7%(自己算的)
- 第二层转述说:下降 8.3%(不知道怎么就改了)
- 第三层转述说:下降 10%,有害(加了语气)
每一步都没有恶意。每一步都只是"没回去看原文"。
但结果是一个确定性的结论,而且它在被无限复制。
(顺便说一句:这篇论文真正有价值的结论——九种方法里最管用的三种是引用来源、专家引言、统计数据,能带来 30-40% 的相对提升——因为不好压缩成一句话,反而很少被转述。能传播的,永远是最简单的那句。)
所以请你记住这一节的分量:
这是一篇你随时能点开原文的、通过同行评审的论文。
它经过两三层转述,都会变形。
那前面那八个追不到源头的商业数字呢?
那 GEO 到底是不是骗局
讲到这儿我必须停下来。因为我知道有读者会得出一个结论:
「所以 GEO 是骗局?」
不是。这个结论是错的,而且它会害了你。
我得把两件事分开——这是这一篇我最想让你带走的分界线:
技术是真的。围绕技术的信息是假的。
先说"技术是真的"长什么样。
- GEO 有一篇被 KDD 收录的奠基论文,九种方法、完整数据表,任何人都能点开原文
- Google 在自己的官方文档里白纸黑字写着「AI 概览和 AI 模式都可能使用查询扇出」——这是它的机制,不是谁的营销话术
- 腾讯在 2024 年 5 月 30 日的发布会上,官方说明元宝接入了微信搜一搜、内容覆盖微信公众号
这三件,都能点到官方源头。
再说"是假的"长什么样。
就是前面那些数字:八个版本的市场规模、对不上的渗透率、每篇都不一样的服务商座次、被改了三遍的论文结论。
它们缺的是同一个东西:可溯源的出处。
所以正确的结论不是"GEO 是骗局",是:
这门技术值不值得做,看机制和实证。 而市面上绝大多数所谓"研究",你不能拿它当依据。
判断一个信息值不值得信,和判断一门技术值不值得做,是两件事。
把它们混在一起,你就会因为"软文太多",错过一个真实存在的入口。
给你三把筛子
那具体怎么分辨?我给你三个问题。以后看到任何一个数字,都可以拿它过一遍。
第一把筛子:能不能点到原始出处?
不是"某报告显示",是那篇报告本身。点进去,你应该能看到:谁做的、什么时候做的、怎么做的。
点不到,就不用。
第二把筛子:有没有说清三件事?
- 样本量:测了多少条、多少个品牌、多长时间
- 时间窗口:哪一年、哪几个月的数据
- 统计口径:算的到底是页面、网站还是品牌
这三件缺任何一件,这个数字就只能当"感觉",不能当"依据"。
回头看那八个版本:它们第一条就全挂了。
第三把筛子:换个人说,还对得上吗?
这一步最关键,也最简单——把两篇讲同一件事的稿子并排看。
我这次就是这么发现那三处"对不上"的:把几个页面摆在一起,286 亿有了两个东家,艾瑞 2025 年有了两个数,信通院的渗透率有了两套说法。
一遍就知道该不该信。
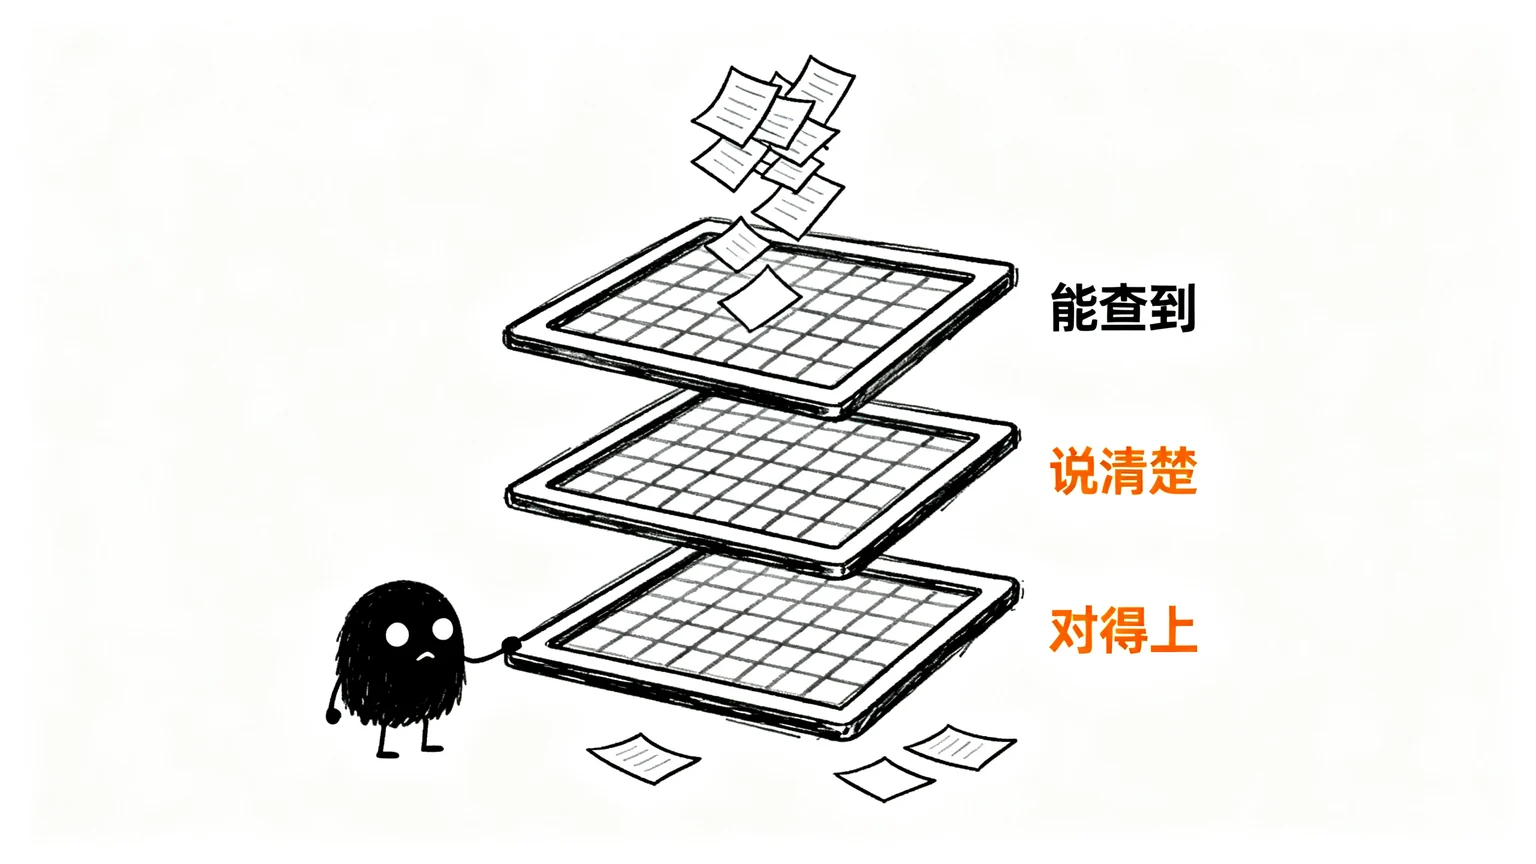 三个问题,一道筛子。上面留下的是能查的,下面漏掉的是查不到的。
三把筛子过完,我给自己定了一条纪律,也是这个系列的纪律:
每个数据都标来源。 是软文,一律不用。
这两句话听着简单,但它有代价——代价是这一篇可能比同类文章"薄"一点。
因为我把用不了的都扔了。
但反过来,你在这个系列里读到的每一个数字,我都能带你找到它从哪来、它有什么地方不能乱用。
顺便说三件正在发生的事
最后,说三件正在发生的事——它们说明:这件事,不只我一个人在意。
第一件:央视曝光过。
2026 年 3 月 15 日的 3·15 晚会,曝光了 GEO 投毒产业链。
调查里,业内人士买了一套叫「力擎 GEO 优化系统」的软件,虚构了一款根本不存在的智能手环,还编了「量子纠缠传感」「黑洞级续航」这种话术。
软件自动生成十余篇软文,自动发布。
两个小时后,去问某个 AI 这款手环怎么样——AI 直接照着那套虚构话术介绍了起来,还给了购买建议。
后来他们又发了十一篇(八篇"专家测评"、两篇"行业排名"、一篇"用户测评"),三天内发完。
然后去问「智能健康手环推荐」,两个大模型都推荐了这款不存在的手环,而且排名靠前。
这就是"从让 AI 记住我,到给 AI 喂假话"中间的那一步。
(这条线怎么防、怎么判,第 11 篇整篇都在讲。)
第二件:行业出标准了。
2026 年 6 月 24 日,国内第一部 GEO 团体标准发布,7 月 1 日起实施。名字叫《商贸流通业生成式引擎优化(GEO)智能营销技术服务规范》,编号 T/CGCC 119—2026,在国家数字标准馆能查到。
它明确禁止的行为里,包括数据投毒、伪背书、伪原创。
但这里我得补一句公道话,也是你在别处听不到的:
这份标准的起草单位里,有 GEO 服务商。
我不想因此否定这份标准。 行业标准由行业企业参与起草,本来就是常态——没有企业,标准根本立不起来。
但你要知道一件事:
"标准"这两个字,本身不等于"权威背书"。
看标准,看它禁止了什么;也看草稿是谁写的。
第三件:监管文件已经施行了。
2026 年 5 月 29 日,国家网信办、公安部、文化和旅游部、市场监管总局、广电总局五个部门联合公布了一份规定,9 月 1 日起正式施行。
《互联网信息内容多渠道分发服务管理规定》——五部门令第 23 号。
它列了一串"不得实施的行为"。其中两条,你一看就知道在说谁:
四、编造背景、情节、人设等,开展虚假或者误导性营销的 五、……通过人工方式或者技术手段实施流量造假或者批量发布同质化内容等行为的
「批量发布同质化内容」——七个字。
前面 3·15 曝光的那套动作,几乎被这七个字写全了。
 曝光、标准、规定。三次出手,说的都是同一件事。
三件事连起来看,你会明白一件事:
这个领域的信息为什么这么乱,不是没人管。
是它在两年里长得太快——快到信息环境自己还没来得及长出秩序。
把这一篇的词一次性翻成人话
老规矩,这张表你随时回来查:
| 术语 | 说人话 |
|---|---|
| 软文 | 收了钱、却被写成"行业观察"样子的推广稿 |
| 溯源 | 一路点回到最早那份原始报告,看它到底怎么算出来的 |
| 口径 | 这个数字"到底算的是什么"——同一件事换个口径,就是另一个数 |
| 样本量 | 测了多少条数据、多少个品牌、多长时间 |
| 转述变形 | 一手结论经过几层转手,语气越来越确定、数字越来越走样 |
| 自指 | 讲 A 的内容,本身也是 A——讲 GEO 的稿子,在用 GEO 的方式传播 |
| 同质化内容 | 同一个模子批量生产、彼此看不出差别的稿子 |
| 团体标准 | 由行业协会牵头制定的标准,不是国家标准;权威性介于"官方"和"自定"之间 |
| 显著性检验 | 判断"这点差异是真差别,还是碰巧"的统计方法。没做这个检验,差异就只是"观察" |
本节动作
五分钟,做一件事:亲手摸一次这个循环。
第一步:找一个月度搜索量够大的词。可以直接用「GEO 市场规模」。
第二步:搜它,点开排名靠前的三篇看起来像"行业观察"的文章。
第三步:把这三篇里的数字一条一条抄下来。同一个指标,三篇各写了多少。
第四步:对每一篇问三个问题:
- 它引的那个数字,点得到原始报告吗?
- 它说清楚了样本量、时间窗口、统计口径吗?
- 这三篇里,有没有哪两个数字是对不上的?
做完你会拿到什么?
一张你自己亲手做出来的"对不上清单"。
它只有一个用处:
以后再有人递给你一个漂亮的数字,你会先问一句"这是谁说的"。
这就是你的第六份基线。
- 第 01 篇:测「有没有被提到」
- 第 02 篇:测「有没有被说对」
- 第 03 篇:测「是从哪儿被提到的」
- 第 04 篇:测「它翻的书在谁手里」
- 第 05 篇:测「换一个平台,它的书还在不在那个人手里」
- 这一篇:测「你手上这份资料,到底值不值得信」
GEO 实验日志 · 第 06 期
先报状态:还是 0。
三个固定问句、六个平台,目前没有一条回答里出现过我。
这一期,我不加问句、不加平台。加第七栏。
前几期我记的都是"结果":有没有被提到、被说对了没有、它引了谁、换个平台是不是还是同一批书。
这一期我要往回退一步,记一件更基础的事:那些"行业数据",我自己信不信。
| 日期 | 平台 | 问句 | 提到我? | 它引用了谁 | 换平台后来源重合吗 | ✅ 新增:数字来源可溯源吗 |
|---|---|---|---|---|---|---|
| — | 元宝 | 问句 A | ○ | — | — | — |
| — | 豆包 | 问句 A | ○ | — | — | — |
| — | DeepSeek | 问句 A | ○ | — | — | — |
| — | 文心 | 问句 A | ○ | — | — | — |
| — | 通义 | 问句 A | ○ | — | — | — |
| — | Kimi | 问句 A | ○ | — | — | — |
还是空的。六个圆圈,四列破折号。
我知道这张表已经连着两期都是空的了。
但它现在多了一个用途——它提醒我:连填这张表都得小心。
因为这张表里的每一个判断,将来我都会拿给客户看。
如果我记的数字本身追不到源头,那这张表就毫无价值。
所以这一栏的意义不在"我",在"数据本身"。
下一次公布:第 07 篇文末。
写在最后
这一篇,我只干了一件事:
把「GEO」这个词,从软文堆里抢回来。
拆开是三件:
- 同一件事八个数字——最大最小差两百倍,还互相挂错东家
- 这批稿子本身就在做 GEO——它们批量生产、试图让 AI 学到它们,所以你问 AI 得到的很可能就是它们
- 连能查到原文的论文都会被转述变形——能查原文的都这样,追不到源头的就更不用说了
但请你一定带走这一句,不然这一篇就白读了:
技术是真的,围绕技术的信息是假的。
别因为软文多,就以为这门技术是空的。
也别因为技术是真的,就信了所有讲它的文章。
这两句听着矛盾,其实是同一件事:
判断信息,和判断技术,用的是两套标准。
今天带走三个问题就够了:
- 点得到原始出处吗?
- 说清样本、时间、口径了吗?
- 换个人说,还对得上吗?
三个都能过,你就用。
过不了,先放着。
这也是这个系列往后每一篇的做法。 你在这里读到的每个数字,我都标了来源;查不过的,我全扔了。
扔掉的那些,比留下的多。 后台留着两页"被丢弃的素材"清单——第 11 篇会挑几个有意思的给你看。
觉得有用就点个赞、在看吧,下次再被"行业报告"绕晕的时候回来看看。
这一篇读完,你应该能做到: 拿到任何一个"行业数据",先问它三个问题——能否点到原始出处、有没有说清样本与口径、换个人说还对不对得上;并且在看到"GEO 市场规模到底多大"这类问题时,知道为什么给不出一个干净答案。
下一篇预告: 第 3 阶 · 第 7 篇《在 AI 眼里,你的公司可能根本不存在》——二阶四篇都在讲"看懂",从下一篇开始要动手了:所有动作之前,先做一次基线诊断。因为没有基线,任何效果都无法证明——这也是整个行业黑盒的根源。