GEO 实战笔记 / 07
在 AI 眼里,你的公司可能根本不存在
有个做工业配件的老板问我"GEO 从哪开始",我反问他一句"你知道现在 AI 是怎么说你这家的吗",他答不上来。这就是绝大多数人的起点——还没测过自己现在什么样,就先想怎么改。但问题是:没有基线,任何效果都无法证明。这就是整个行业黑盒的根源——服务商说"我给你做上去了",你拿什么反驳?这一篇给一套可以直接照着
本篇目录
我是醒醒,AI共学社主理人,30岁程序员转型一人公司践行者。闲鱼+小红书变现五位数,已帮500+人用AI为工作提效。不教你追工具,只帮你用AI解决问题、赋能业务。长期主义者,专注让AI真正落地到你的工作里。
GEO 实战笔记 · 第 07 篇 你现在在哪:第 3 阶 · 上手(开篇) 这一篇带你去哪:自己动手做完一次 AI 可见度自检,拿到属于你的第一份基线
上周有个做工业配件的老板找我。
开口第一句:「GEO 我想做,从哪开始?」
我没答,先反问了一句:
「你知道现在去问 AI,它是怎么说你这家的吗?」
他愣了两秒。
「……没试过。」
那就对了。
因为绝大多数人都是这么开始的。
先说一个反常识的事:AI 认识你,不等于 AI 推荐你
上一阶的四篇,我们一直在讲"看懂了什么"。
AI 怎么翻你的页面、怎么挑信源、六个平台的口味差在哪、还有那堆软文为什么不能信。
原理这一层,到这里够了。
从这一篇开始,要动手了。
而动手的第一步,不是写内容,不是改官网,也不是投钱。
是测一下你现在站在哪。
为什么?我先给你一个数据,你看完大概会坐直。
有一个覆盖 175 个品牌、8 个 AI 平台、五个行业(法律、医疗、SaaS、金融、电商零售)的研究,做了两组测试:
第一组:直接问 AI「某某公司是做什么的」。
结果:96% 的品牌,AI 都能准确说清楚。
第二组:换成真实买家会问的那种问题——「这个领域里哪家值得选」「有什么替代方案」。
结果:同一批品牌里,89% 一次都没出现过。
96% 对 89%。
AI 知道你,和 AI 推荐你,是两件完全不同的事。
这句话你可能有感觉,但未必有体感。
我换个说法:
AI 手里有一本花名册,你在上面。但客户来问"该找谁"的时候,它不念你的名字。
花名册上有没有你,是它了不了解你。
念不念你的名字,才是你有没有生意。
而这个研究真正的价值在于——它戳破了一个很舒服的错觉。
很多老板的心智模型是这样的:
AI 都知道我是干什么的了 → 那客户问的时候,它自然会提到我。
不自然。
它知道,和它说,中间隔着一整套选择机制。
先声明一句,这也是我做这个系列的纪律:这个研究是服务商自己做的(一家做 SEO 服务的公司 Victorious),没有经过第三方复现,它给的是相关性、不是因果。
我把局限先摆出来。
但它值得我用,因为方向性结论有三组独立数据在交叉印证——后面我会一条条摆给你看。
先记住这个落差就够了。
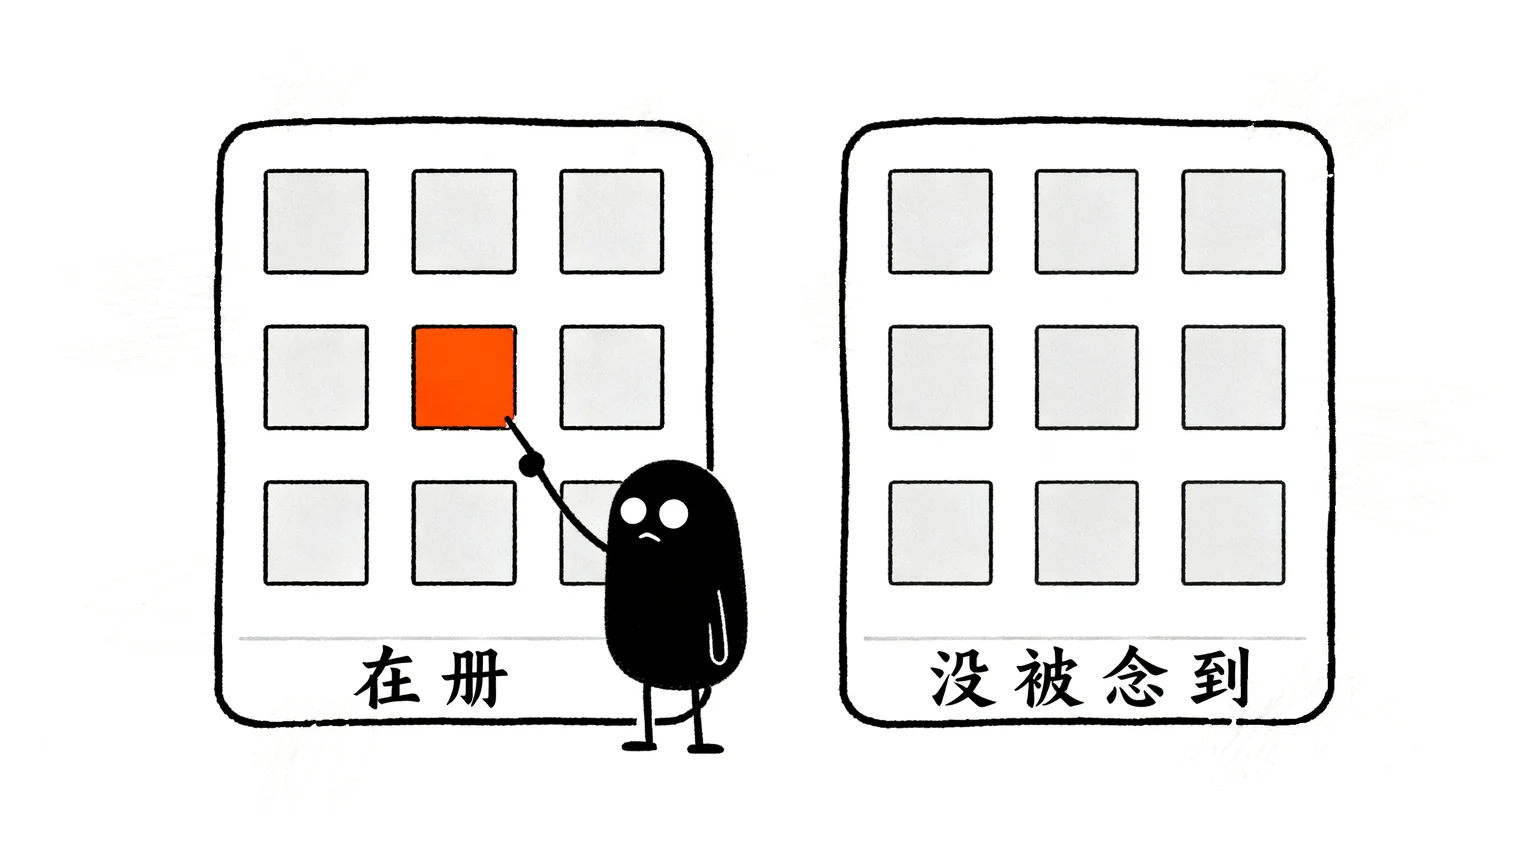 在花名册上(左),和被人念出名字(右),是两码事。
为什么必须先体检:没有基线,效果就无法证明
你可能会想:知道了知道了,AI 不推荐我,那我赶紧去优化不就行了?
先等等。
我要讲的不是"优化"。
是"你根本不知道现在优化没优化"。
这里有一个场景,你大概率遇到过,或者将来一定会遇到。
半年后,你找了一家服务商做 GEO,花了钱。
三个月过去,你问他:效果怎么样?
他给你一张图,说:「看,你现在被引用的次数涨了三倍。」
你怎么反驳?
你反驳不了。
因为你手里什么都没有。
你不知道三个月前是多少,你不知道"三倍"是从几开始的,你甚至不知道他测的是哪个平台、问的是哪句话。
这就是整个行业黑盒的根源。
不是服务商一定在骗你。 是你没有基线,所以真话假话你都验不了。
再补一句更要命的:
GEO 的效果本来就有延迟。 内容被收录、被检索、被稳定引用,中间隔着时间——快的话几天,稳的话要持续输出几周甚至几个月。
也就是说,你付钱之后的头一个月,大概率什么都看不出来。
那这一个月里,你拿什么判断他在干活还是没干活?
只能靠基线。
基线是什么?说人话:
你今天,此刻,在各家 AI 里长什么样。
- 哪些平台知道你
- 哪些平台压根没听说过你
- 提到你的时候,说的是什么
- 排在什么位置
这四件事,你先测一遍、原样记下来。这份记录就是你的基线。
有了它,三个月后你才能说:「等等,这个平台的回答变了,从没有我变成提到我了。」
或者——「三个月了,一个字没变。」
这两句话,都是证据。
没有基线,你连这两句话都说不出来。
所以这一篇不教你写内容。
只教你做一次体检,拿到你的基线。
三类问句:品牌词是照镜子,品类词才是考场
体检怎么测?
不是随便问。
问题怎么设计,直接决定你测出来的是真结果,还是自我安慰。
我把它分成三类。这三类的区别,是这一篇最值钱的地方。
| 类型 | 长什么样 | 谁在问 |
|---|---|---|
| 品牌词 | 「XX 公司怎么样」「XX 可靠吗」 | 已经知道你的人 |
| 品类词 | 「XX 行业哪家好」「XX 怎么选」 | 正在挑供应商的人 |
| 问题词 | 「XX 问题怎么解决」 | 还没想好要买什么的人 |
第一类:品牌词 —— 照镜子,没意义。
你问 AI「XX 公司怎么样」,它当然认识你。
因为你已经把名字喂给它了。
有个测了 5,055 场 ChatGPT 对话、131 个 B2B 品牌的研究,把这件事量化了:
品牌词问句里,品牌出现率是 99.9%。
一千零六十五次里,有一千零六十四次提到了。
99.9% 这个数字,不是成绩,是废话。
它只说明一件事:AI 的数据库里有你。
但这不产生任何生意。 因为会这么问的人,早就知道你是谁了——他不需要被推荐,他需要的是被确认。
你把这一格填成"有",等于什么都没测。
第二类:品类词 —— 这才是考场。
同一个研究里,把问句换成不点名任何品牌的自然问法——就是买家在还拿不定主意时会问的那种——品牌的自然出现率掉到:
12.2%。
从 99.9% 掉到 12.2%。
这中间掉下去的,全是生意。
再看一个细节,我觉得比数字本身更扎心:
131 个品牌里,有 29 个,在任何自然问句里一次都没出现过。
接近六成的品牌,在一百场自然对话里,出现不超过十次。
而会问品类词的人,正是那些还没决定找谁的人。
他们是你最不能丢的客户——因为他们还没形成偏好,谁先被提到,谁就先进入他们的候选名单。
AI 在这一刻念不念你的名字,就是你的天花板。
第三类:问题词 —— 最容易漏的一类。
这一类的场景是这样的:
客户还不知道自己需要哪类方案。他在问:「我这个情况该怎么办?」
他连该找什么都不知道,当然也不会问品牌。
那 AI 会怎么答?
它会去找科普型的内容——讲清原理、讲清方法、讲清什么情况该用什么方案的那种。
而这类内容,很多就是企业自己写的。
你以为你的科普内容在帮你?真相是这个:
在那个研究里,AI 确实大量参考了公司官网的科普内容,但——
品牌名被明确提到的比例,只有 0.10%。
千分之一。
也就是说:
你的内容在被用,但功劳记不到你头上。
你在替整个行业做科普,AI 拿着你的内容去回答客户,然后没有一次告诉客户这是你写的。
这三类问句连起来看,你就明白为什么"体检"不能随便问了:
- 只测品牌词 → 你得到 99.9% 的假安心
- 只测品类词 → 你看到真实的残酷
- 漏掉问题词 → 你不知道自己的内容正在免费给别人打工
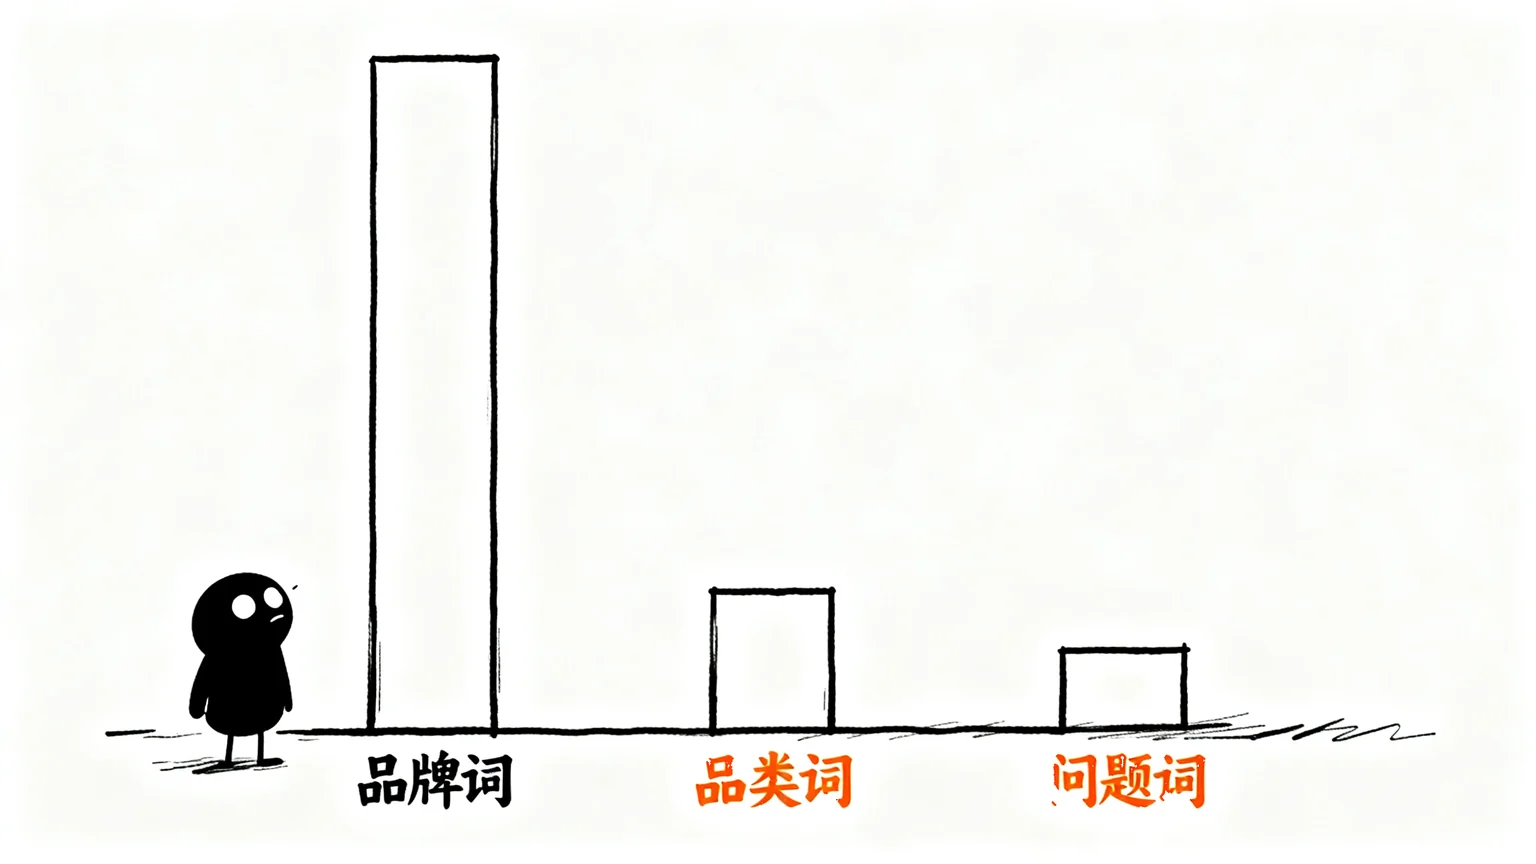 品牌词是照镜子(左),品类词是考场(中),问题词是——你的内容在被用,名字被抹掉(右)。
一句话记住:
品牌词是照镜子,品类词才是考场。问题词是你免费出的题。
六平台 × 三类问句:把这张表抄下来就是你的检测单
好,方法有了。现在给你能直接照着做的东西。
先说为什么是六个平台。
第五章我们讲过:六个平台的信源池不一样,换一台机器,结果会重算一遍。
有个专门测这件事的研究,拿同一批品牌去分别问:
同一个品牌,在 ChatGPT 被提到的比例是 33%,在 Perplexity 是 83%,在 Gemini 也是 83%。
同一个品牌、同一批问题,换一个平台,差两倍半。
所以——你只测一个平台,等于没测。
国内的六个,就是你平时会用的这六个:
豆包 / 元宝 / DeepSeek / 文心 / 通义 / Kimi
下面是你的检测单。直接抄。
【AI 可见度自检表】
第一步:给自己出 6 个问题。
三类各出两个——数量随你,但三类必须都有。
| 类型 | 你要填的问句(示例) |
|---|---|
| 品牌词 ① | 「〔你的公司名〕怎么样」 |
| 品牌词 ② | 「〔你的公司名〕靠谱吗」 |
| 品类词 ① | 「〔你的行业〕哪家好」 |
| 品类词 ② | 「〔你的行业〕怎么选」 |
| 问题词 ① | 「〔你的客户遇到的典型问题〕怎么解决」 |
| 问题词 ② | 「〔你的客户遇到的典型问题〕该找谁」 |
填的时候记住三条规矩:
- 品牌词里别加形容词。 就写公司名,别的都不加——加了就是你引导它
- 品类词里绝对不能出现你的公司名。 出现一次,这一格就废了
- 问题词要写客户的原话。 别写行业黑话,写他跟朋友吐槽时的那种说法
第二步:六个平台,各问一遍。
| 平台 | 品牌词① | 品牌词② | 品类词① | 品类词② | 问题词① | 问题词② |
|---|---|---|---|---|---|---|
| 豆包 | ||||||
| 元宝 | ||||||
| DeepSeek | ||||||
| 文心 | ||||||
| 通义 | ||||||
| Kimi |
每一格就填一个字:
- 有 —— 回答里提到了你
- 无 —— 没有提到你
- 错 —— 提到了,但说错了
⚠️ 三点必须提醒:
- 要开联网搜索。 很多平台的 App 默认不开,不开的话它答的是训练数据里的老印象,测出来不准
- 同一个平台、同一个问题,隔天再问一次。 有研究实测过:同一个模型自己跟自己隔天跑,提到的公司重合度也就刚过半——这不是你测错了,这就是它的本性
- 别用"我觉得"。 就记"有/无/错"三个字。体检表不是作文
第三步:把"有"的那几格,再看两件事。
| 附加项 | 记什么 |
|---|---|
| 它怎么描述你 | 一句话抄下来。准不准、是不是过期信息 |
| 它引用了谁 | 回答下面那些来源链接,点到的是你的官网,还是别人的页面 |
这一步是分水岭。
因为只要它开始提你,你就要知道它是从哪儿知道你的——这决定了你后面该往哪儿使劲。
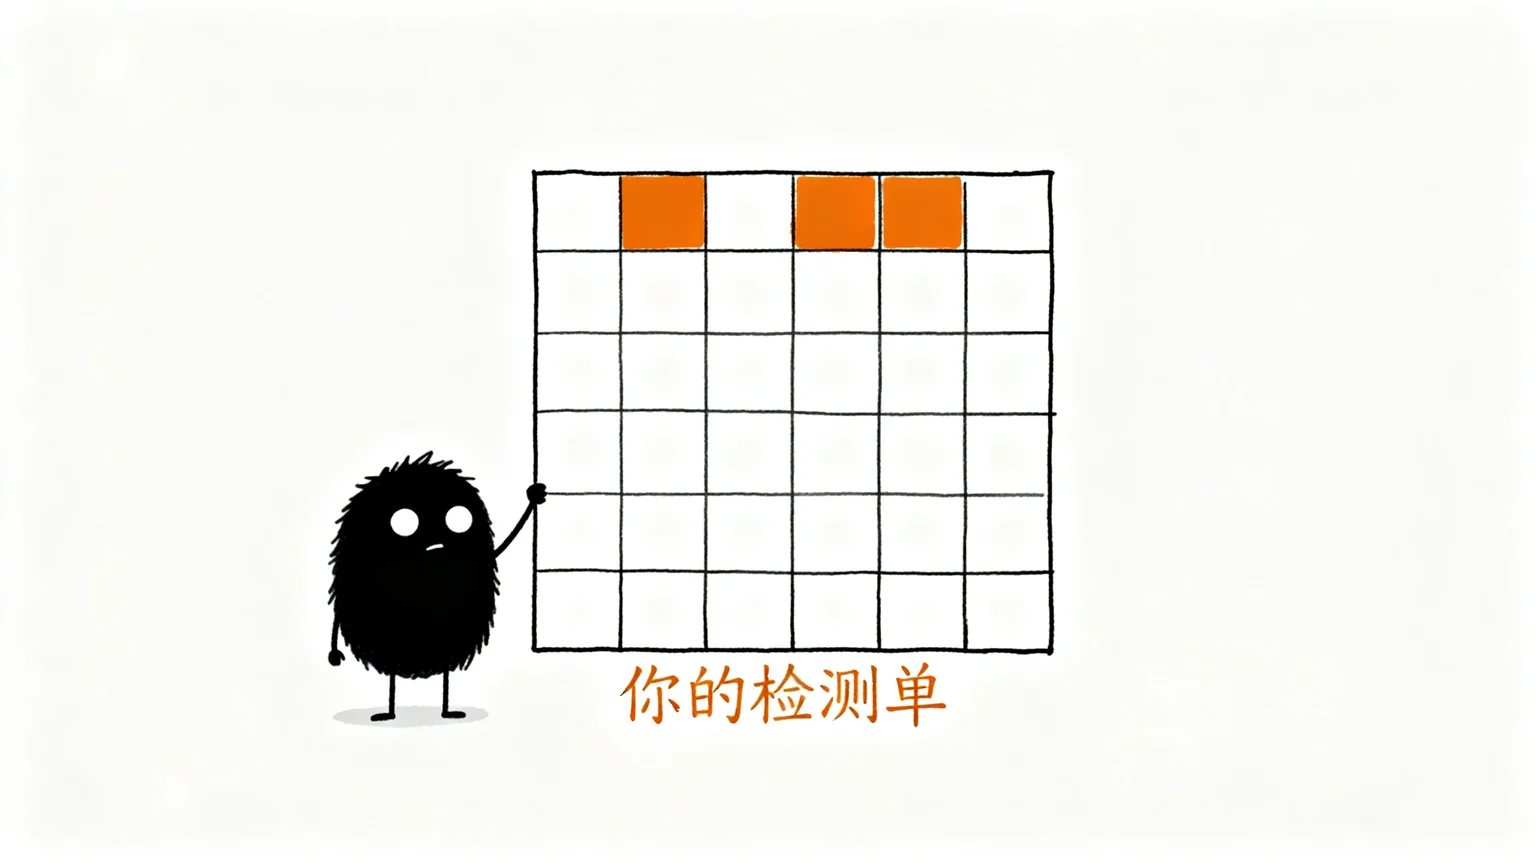 六行六列,一格一个字。抄下来就是你的基线。
就这么简单?对,就这么简单。
但你现在可以想一下:这件事,你以前做过吗?
测完你会拿到三种结果,最坏的不是"不存在"
跑完那一张表,你会落在三种情况里。我按从好到坏排——注意,最好的不是第一种。
第一种:完全不存在。
六个平台、六大类问句,一格都没提到你。
很多人测完就想关电脑。
别急。这其实不是最糟的。
为什么?因为"不存在"是一个干净的起点。
没有错误信息要清理,没有旧印象要纠正,你要做的只是从零开始建。
而且这件事有个更温和的说法:
你不是做得差,你是还没被看见。
第二种:存在,而且描述准确。✅
这是最好的情况。
AI 认识你,说起来也对。
那你这一篇的任务就不是"从零开始",而是"从品类词那一行开始"。
因为——回到那个 96% 对 89%。
AI 认识你,不代表它推荐你。
你的战场在品类词那一栏。 前面三格有"有",后面三格全"无",那才是你真实的位置。
第三种:被提到,但被说错了。❌
这是最坏的一种。
比"不存在"还坏。
为什么?
因为错误信息会被反复引用。
AI 是靠读东西形成印象的。它读到一篇写错的稿子,就会把这句话记住,然后在回答别人时说出来。
然后别人(包括其他 AI)再读到它的回答。
错误就这么长出了一层新的根。
我给你看一个真实发生过的例子,你就明白它的机制——
2026 年 3·15 晚会曝光过一件事:
有人虚构了一款根本不存在的智能手环,编了「量子纠缠传感」「黑洞级续航」这种话,用软件自动生成十几篇软文发出去。
两个小时后去问 AI,AI 照着那套虚构话术介绍了起来。
后来他们又发了十一篇,三天内发完。
再去问"智能健康手环推荐",两个大模型都推荐了这款不存在的手环,而且排名靠前。
你把这件事反过来看,就是你现在的风险:
如果关于你公司的那批稿子里,有错的、有过期的——AI 会照着念。
而且它会念得很自然、很肯定。
那"被说错"具体长什么样? 通常是这几种:
- 信息过期:你三年前的产品线、已经停掉的业务,AI 还在说
- 张冠李戴:把同行的案例、别人的资质,安在你头上
- 口径变了:你现在做的是 A,但网上全是关于 B 的旧内容
为什么它比"不存在"难修?
因为"不存在"你只要加法——往里加内容就行。
"被说错"你要先做减法——得先让那批错的、旧的页面的权重降下去,再建新的。而新内容要盖过旧内容,需要时间,也需要更多的正确信源同时说话。
一句话:
没有记录,你可以写上去。 写错了的记录,你要先把旧的擦干净。
顺手给你一个参照量。
那个 175 个品牌的研究里,还测了一个很有意思的东西——看"外部提到你的页面有多少",和"AI 会不会提你"的关系:
| 提到你的第三方页面数(不含自家网站) | AI 提到你的比例 |
|---|---|
| 少于 2000 | 3% |
| 2000 – 1 万 | 25% |
| 1 万 – 3 万 | 47% |
| 3 万以上 | 64% |
少于 2000 的时候,3%。
翻译成大白话:
在一个典型的品牌身上,如果全网提到它的第三方页面不到两千个,那它在 AI 的品类回答里被点名的概率,约等于零。
这条数据我不建议你拿去当 KPI——它是服务商数据集里的关联,不是通用标准,跟行业强相关。
但它能帮你校准一件事:
你在 AI 里的可见度,主要不是由"你自己的网站"决定的,是由"别人怎么谈你"决定的。
这个研究里另外几组数字也指向同一处:
- 品牌被提到时,AI 用来说明它的话,44% 来自竞品的内容、39% 来自其他第三方,只有约 六分之一 来自品牌自己网站
- 相关度最高的信号是"引荐域名"(0.49)和"第三方提及"(0.45)——都是站外的
- 而知识图谱有没有你,和 AI 提不提你,没有稳定关系
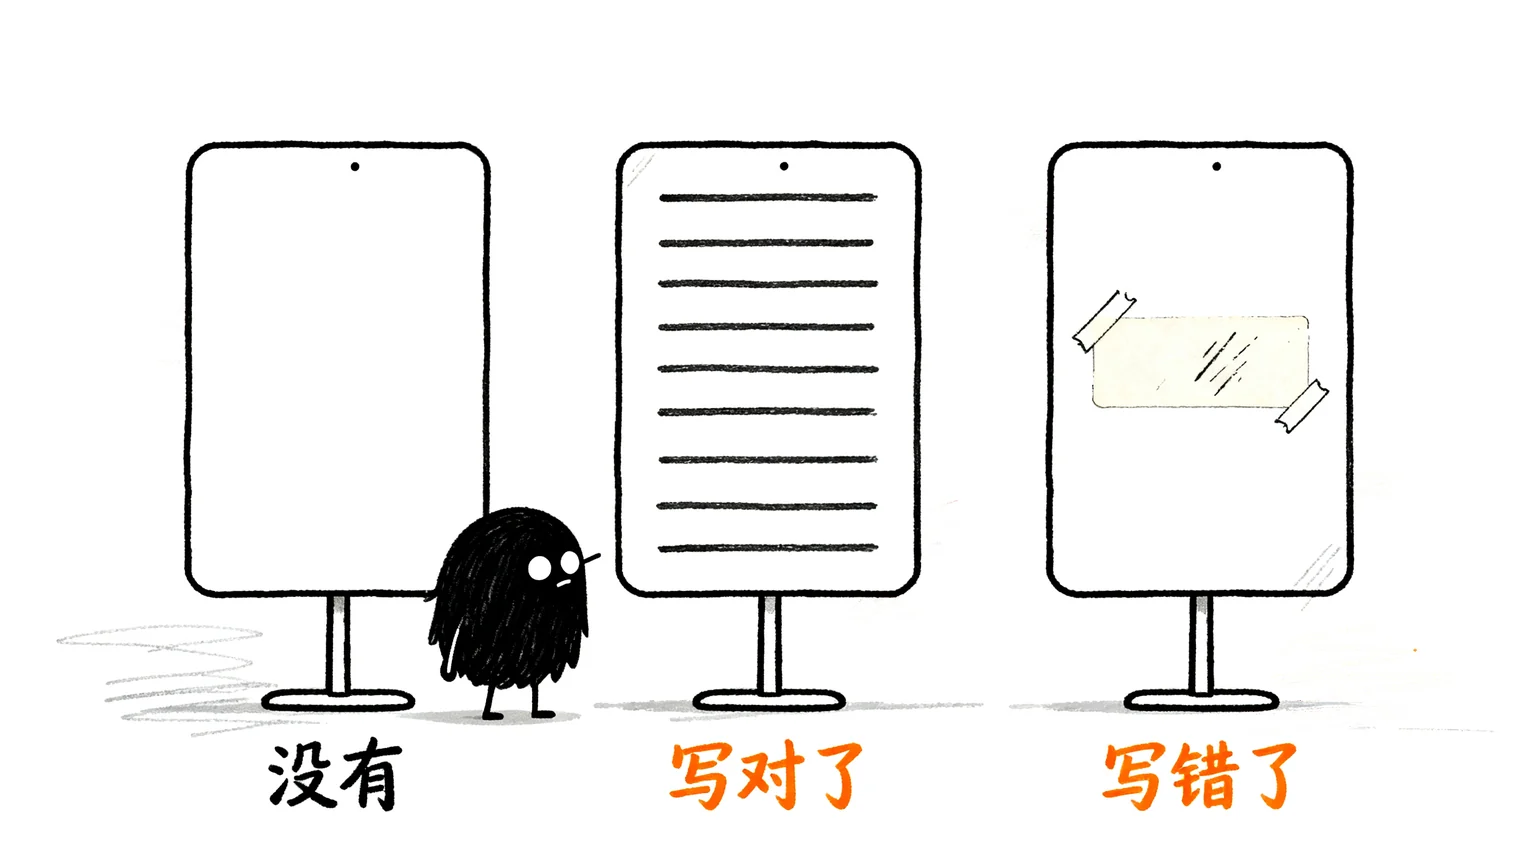 不存在(左)不可怕,可怕的是中间那种——挂着你的名字,写着别人的话。
每一格要记哪些字段
体检不是看一眼就完了。要留档。
因为你三个月后要拿它对比。
下面这张表,是你要开工前就建好的。
| 字段 | 填什么 |
|---|---|
| 日期 | 例:2026-10-04 |
| 平台 | 豆包 / 元宝 / DeepSeek / 文心 / 通义 / Kimi |
| 问句 | 你原样写的那句话 |
| 类型 | 品牌词 / 品类词 / 问题词 |
| 联网了吗 | 开 / 没开(这条别漏,漏了数据作废) |
| 提到我了吗 | 有 / 无 / 错 |
| 排在第几 | 如果提到了,它在推荐列表里排第几 |
| 它怎么描述我 | 原话抄下来,别总结 |
| 它引用了谁 | 来源链接里,是你的站,还是别人的站 |
| 和上次比 | 变了没有,往哪个方向变 |
十条。看着多,其实每一格就写几个字。
最后一条是灵魂——因为它就是你三个月后判断"钱花得值不值"的唯一依据。
我再强调一遍这个系列的纪律:
这张表里的每一个数字,将来都会被我拿给客户看。
如果我记的东西本身追不到源头、经不起复现,那这张表就毫无价值。
所以:宁可空着,不要编。
把这一篇的词一次性翻成人话
老规矩,这张表你随时回来查:
| 术语 | 说人话 |
|---|---|
| 基线 | 你今天、此刻在各家 AI 里的样子。没有它,之后所有变化你都判断不了 |
| 品牌词 | 问句里点了你的名字。AI 当然认识你,测了等于没测 |
| 品类词 | 问句里不点任何品牌,只问"这行谁行"。这才是真正的考场 |
| 问题词 | 客户连该找什么都不知道时问的问题。你的内容会被用,名字容易被抹掉 |
| 可见度 | 你在 AI 回答里出现的程度。注意:认识你 ≠ 提到你,提到你 ≠ 推荐你 |
| 联网搜索 | 平台去现搜网上的资料再回答。开不开,测出来的结果完全不同 |
| 第三方提及 | 不是你自己发的、但提到了你的那些页面。AI 对你的印象主要来自这里 |
| 引用来源 | AI 回答下面附的那些链接。它指向谁,说明它这次是听谁的 |
| 隔天复测 | 同一问题隔一天再问一次。同一模型自己跟自己重合度也就刚过半,复测是必须的 |
本节动作
五分钟起步——但这一篇的动作,我建议你留半小时。
因为它值得。
第一步:按上面的表,给自己出 6 个问句(品牌词 ×2、品类词 ×2、问题词 ×2)。
第二步:打开六个平台,确保联网搜索是开的,把 6 个问题各问一遍。
第三步:只记三个字——有 / 无 / 错。填满那张 6×6 的表。
第四步:把有"有"或"错"的格子,把 AI 描述你的原话抄下来,再点开它引用的来源,看看是谁。
做完你会拿到什么?
你的第一份 AI 可见度基线。
它有三个用处:
- 它是你三个月后判断效果的唯一依据
- 它告诉你战场在哪——是品类词那一栏,还是先把错误信息清掉
- 它让你之后跟任何人谈 GEO 的时候,手里有数
这就是你的第七份基线。
- 第 01 篇:测「有没有被提到」
- 第 02 篇:测「有没有被说对」
- 第 03 篇:测「是从哪儿被提到的」
- 第 04 篇:测「它翻的书在谁手里」
- 第 05 篇:测「换一个平台,它的书还在不在那个人手里」
- 第 06 篇:测「你手上这份资料,到底值不值得信」
- 这一篇:测「你自己,现在到底站在哪」。
GEO 实验日志 · 第 07 期
报状态:还是 0。
三个固定问句、六个平台,目前没有一条回答里出现过我。
但这一期不一样。
因为这一期,我第一次能把那张表真的填完——不是填"提到我没提到我",是填我自己的基线长什么样。
前面六期我一直在报"结果"。这一期我把"结果栏"和"基线栏"分开:
| 日期 | 平台 | 问句 | 类型 | 提到我? | 它引用了谁 | 上期对比 |
|---|---|---|---|---|---|---|
| — | 豆包 | 品牌词 | 品牌词 | ○ | — | — |
| — | 元宝 | 品牌词 | 品牌词 | ○ | — | — |
| — | DeepSeek | 品牌词 | 品牌词 | ○ | — | — |
| — | 文心 | 品牌词 | 品牌词 | ○ | — | — |
| — | 通义 | 品牌词 | 品牌词 | ○ | — | — |
| — | Kimi | 品牌词 | 品牌词 | ○ | — | — |
六个圆圈。
唯一的新东西是:这一篇之后,我知道该怎么填了。
我知道要先出三类问句,知道要开联网,知道要隔天复测,知道每一格该记什么。
这些都不是结果。但这些是"能测出结果"的前提。
而且我现在能说一句更实在的话了:
这个系列做了七期,数据一直是 0。这件事本身,就是这一篇最诚实的证据。
我没有先做出一堆漂亮数字再来教你,我是先把自己摆在测试台上,然后告诉你现在测出来是什么。
下一次公布:第 08 篇文末。
写在最后
这一篇,我只干了一件事:
把"GEO 从哪开始"这个问题,从"怎么优化"改成了"先测一遍"。
拆开是三件:
- AI 认识你 ≠ AI 推荐你——96% 对 89%,中间隔着的全是生意
- 三类问句,缺一不可——品牌词是照镜子(99.9%,废话),品类词才是考场(12.2%,残酷),问题词是你免费出的题(0.10%,名字被抹掉)
- 六平台 × 六问句,一格一个字——这张表抄下来就是你的基线
但请你一定带走这一句,不然这一篇就白读了:
没有基线,任何效果都无法证明。
这句话有两个方向都用得上:
对着你自己——你不知道现在什么样,就不知道三个月后变没变。
对着别人——他拿不出基线,你就没法判断他到底干没干活。
这也是这个行业黑盒的根。 不是所有人都想骗你,是连想好好给你看的人,都没法给你看。
所以今天你只需要做一件事:
去测你自己的那一版。
测完把它存好。
它现在什么都证明不了。但它将来能证明很多事。
觉得有用就点个赞、在看吧——顺手把那张检测表存下来,三个月后你会庆幸今天测过。
这一篇读完,你应该能做到: 给自己出三类问句(品牌词 / 品类词 / 问题词),在六个平台各跑一遍,把结果填进一张 6×6 的表,并记录每个"有"或"错"的格子背后的描述与引用来源——也就是拿到属于你自己的第一份 AI 可见度基线。
下一篇预告: 第 3 阶 · 第 08 篇《让 AI 愿意引用你,真正有效的只有 5 个动作》——体检做完了,知道自己站在哪了,接下来是动手改。这一篇要给的是全系列收藏率最高的一份:五个可以直接照着改的动作,每个都配"改前 / 改后"的句子对照。同时我会先泼一盆冷水:网上疯传的"提升 40%"说的根本不是流量,而且同一套动作,排第一的人做了可能反而掉。下一篇讲清楚为什么。