GEO 实战笔记 / 13
独立站 GEO 的技术底座:先让 AI 读得到
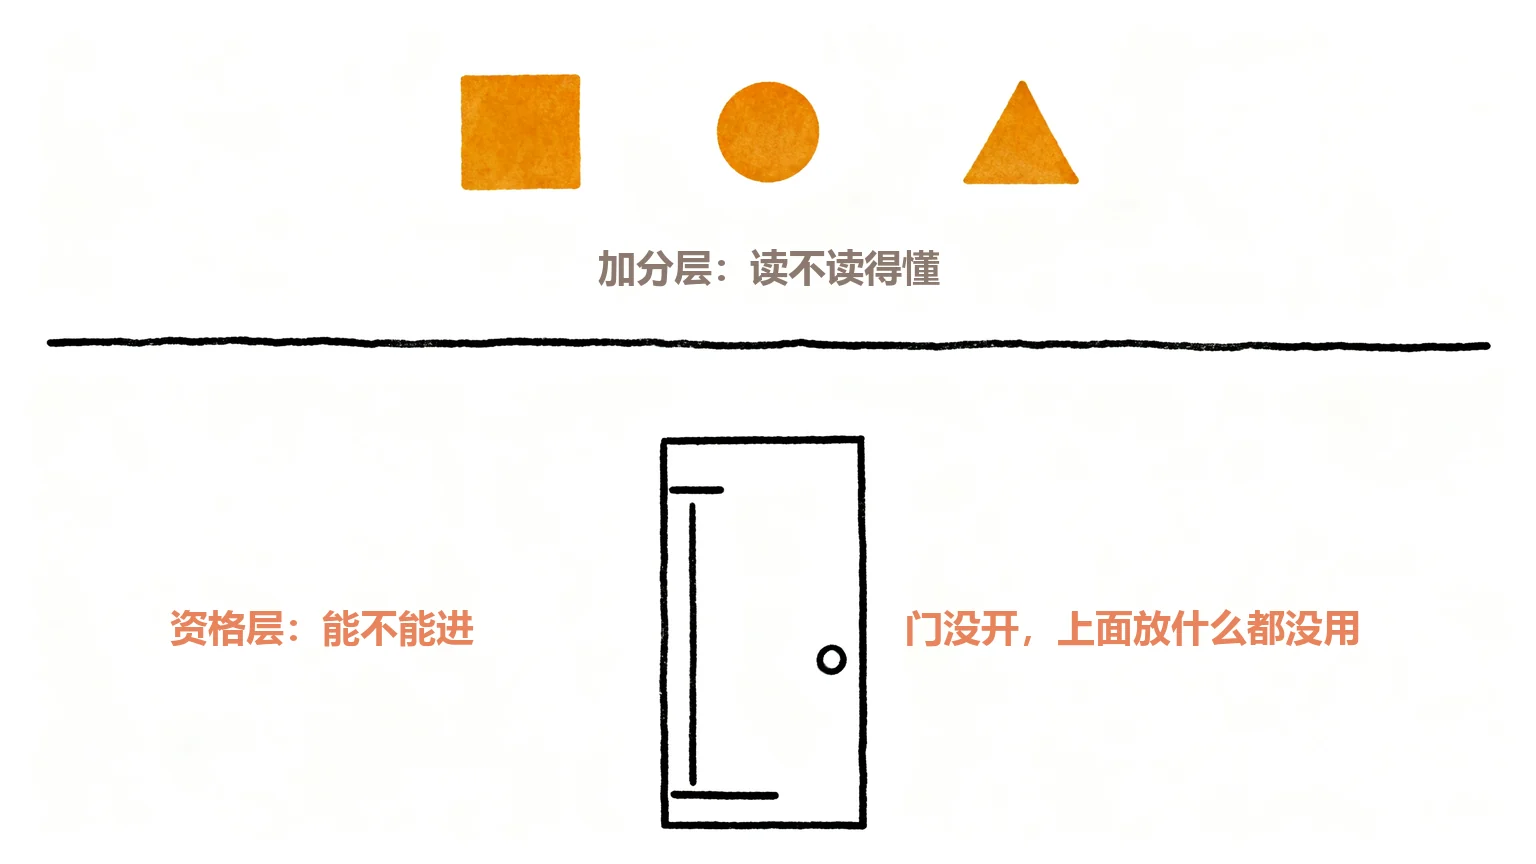
独立站做 GEO 只有两层:先保证 AI"进得来、读得到",再谈"加不加分"。而大部分人 80% 的预算花在了第二层——Google 官方在 2026 年 5 月的指南里,正好点名了那一层里最热卖的两样东西。这一篇给你一张分四层、19 项、可以逐项打勾的清单,以及两份能直接复制的配置模板。
本篇目录
我是醒醒,AI共学社主理人,30岁程序员转型一人公司践行者。闲鱼+小红书变现五位数,已帮500+人用AI为工作提效。不教你追工具,只帮你用AI解决问题、赋能业务。长期主义者,专注让AI真正落地到你的工作里。
GEO 实战笔记 · 第 13 篇 你现在在哪:第 5 阶 · 进阶(独立站 / 出海专线 · 第 2 篇) 这一篇带你去哪:拿到一张能逐项打勾的技术清单,知道先修哪、后修哪、哪些根本不用修
一个做五金工具的老板,花了五万,AI 一次都没提他
去年他花了三万重做独立站,做了一轮 SEO。今年年初,又花两万买了一个"GEO 优化包"。
服务商给的回执很漂亮:部署了 87 处结构化数据、生成了 llms.txt、给 FAQ 做了标记。
他来找我的时候,问题问得很直接:
"我花了五万,为什么在 ChatGPT 里搜我的品类,一次都没提到我?"
我让他做了两件事。
第一件:在浏览器里禁用 JavaScript,然后打开他自己最重要的那个产品页。
他打开之后停了几秒,说:"参数呢?"
对。他的产品页是前端渲染的——材质、承重、认证、包装尺寸,都是 JS 从接口把数据拉回来再显示的。不执行 JavaScript 的访问者,看到的是一个空框。
而 AI 的爬虫,不执行 JavaScript。
第二件:把他的 robots.txt、CDN 后台、建站插件设置全翻出来。
结果更离谱。他的站挂在一家 CDN 上,而那套"企业级安全防护"的默认规则,按 UA 拦掉了一大批机器人。他完全不知道。
所以那两万块钱做的事是:在一个 AI 进不来的门口,贴了一张装修得很好的使用说明。
不是你的内容不好。是 AI 连门都进不来。
这一篇要给你一张清单,不是一个方法
上一篇我们讲清楚了"为什么独立站必须加 GEO 这一层"。
这一篇讲具体动作:修什么、按什么顺序修。
我会给你一张清单,分四层,一共 19 项。前两层是必须做的;第三层是一天能做完的;第四层是"想发就自己发、但别花钱"的。
先说清楚:这一篇会让你少花钱,所以它会得罪一些人。
现在市面上有一门生意叫"GEO 优化包",报价从几千到几万,里面通常有两项标配——给你的站部署结构化数据(Schema),和给你生成一个 llms.txt 文件。
这两件事,下面会一件一件拆。先给结论:它们不是没用,是"不是那个用"。
如果你现在连"AI 能不能进你的站"都还没确认,先买这两样,就等于先装修、后开门。
先说一件得罪人的事:Google 官方点名了五件事
2026 年 5 月 15 日,Google 搜索中心发布了一份此前从未有过的文档:《为 Google 搜索的生成式 AI 功能优化你的网站》。
这份文档最值得看的,不是它说"该做什么"——那部分全是你早就听过的老话。最值得看的是它单独开了一节,标题就叫 mythbusting(破除迷思),点名了五件"可以忽略"的事:
| Google 点名的做法 | 官方的意思 |
|---|---|
| llms.txt 之类的 AI 文本文件 | 不需要 |
| 把内容切块(chunking) | 不需要 |
| 专门为 AI 改写文案 | 不需要 |
| 制造不真实的品牌提及 | 不要做 |
| 过度依赖结构化数据 | 别指望它 |
第三、第四项先放着。第一项和第五项,正好对应现在最热卖的两项 GEO 服务。
Google 的原话是这样的:
您无需创建新的机器可读文件、AI 文本文件或标记,即可在这些功能中显示内容。您也不需要添加任何特殊的 schema.org 结构化数据。
这句话分量重,因为它是规则制定者自己说的。
在这个行业里,绝大多数"该怎么做"的说法都是推测,而推测的来源是相关性——"我看了一百个被 AI 引用的页面,其中 53% 有 Schema,所以 Schema 有用"。
但「53% 的引用页面有 Schema」和「加了 Schema 就会被引用」,是两件完全不同的事。
打个比方:你去看 100 个考进重点班的学生,发现其中 53% 都买了同一套教辅。你能得出"买这套教辅就能考进重点班"吗?
不能。因为更可能的原因是:能考进重点班的学生,本来就更容易去买教辅。 教辅是他们"学习习惯好"的一个副产品,不是原因。
结构化数据就是这个道理。做了 Schema 的站,通常也是维护更勤、内容更好、排名更高的站。 这些站本来就会被引用。
这就是本篇的第一个判断方法:看见"某某比例的 AI 引用页面都有某样东西",先问一句"反过来成不成立"。
还要说清一件事:这不是说 Google 在打击 Schema。 相反,Google 自己仍在推荐你把 Schema 当常规 SEO 的一部分用。它反对的只有一件事——把 Schema 当成 AI 可见性的抓手。
而且有一条边界必须说明:这份指南只管 Google 自家的 AI 界面(AI 概览、AI 模式)。ChatGPT、Perplexity、Claude 各有各的检索架构,Google 的话不能直接搬过去。
但有意思的是——别家最后指向的,是同一个地方。
做独立站 GEO,只有两层:能不能进,和加不加分
在讲动作之前,先把地图给你。
所有技术动作,其实只分成两层:
| 层 | 它管什么 | 做错的后果 | 性质 |
|---|---|---|---|
| 资格层 | AI 能不能进来、能不能读到 | 直接归零 | 0 或 1 |
| 加分层 | 读到之后,能不能更好地理解你 | 不归零,但不保证有回报 | 放大器 |
资格层只问一个问题:你的页面,AI 抓得到吗、读得懂吗?
这一层没有中间状态。抓不到就是抓不到,读不到就是读不到。AI 不会因为你内容好,就翻墙进来。
加分层问的是另一个问题:AI 读到了你,它有没有把你的内容归属到一个清晰的身份上。
它的性质是放大器,不是发动机。它会把已有的优势放大,也会把已有的混乱放大,但它不会凭空创造优势。
⭐ 这一篇的核心只有一句:一个被挡在门外的页面,写什么标记都没用。
而现在大部分独立站的预算分配是反的:
- 加分层(买 Schema 服务、生成 llms.txt):花掉八成预算
- 资格层(确认爬虫进得来、参数写进 HTML):花掉零
下面两节,一层一层拆。
第一层:三种爬虫,三道门
这是最容易出错、后果也最严重的一节。
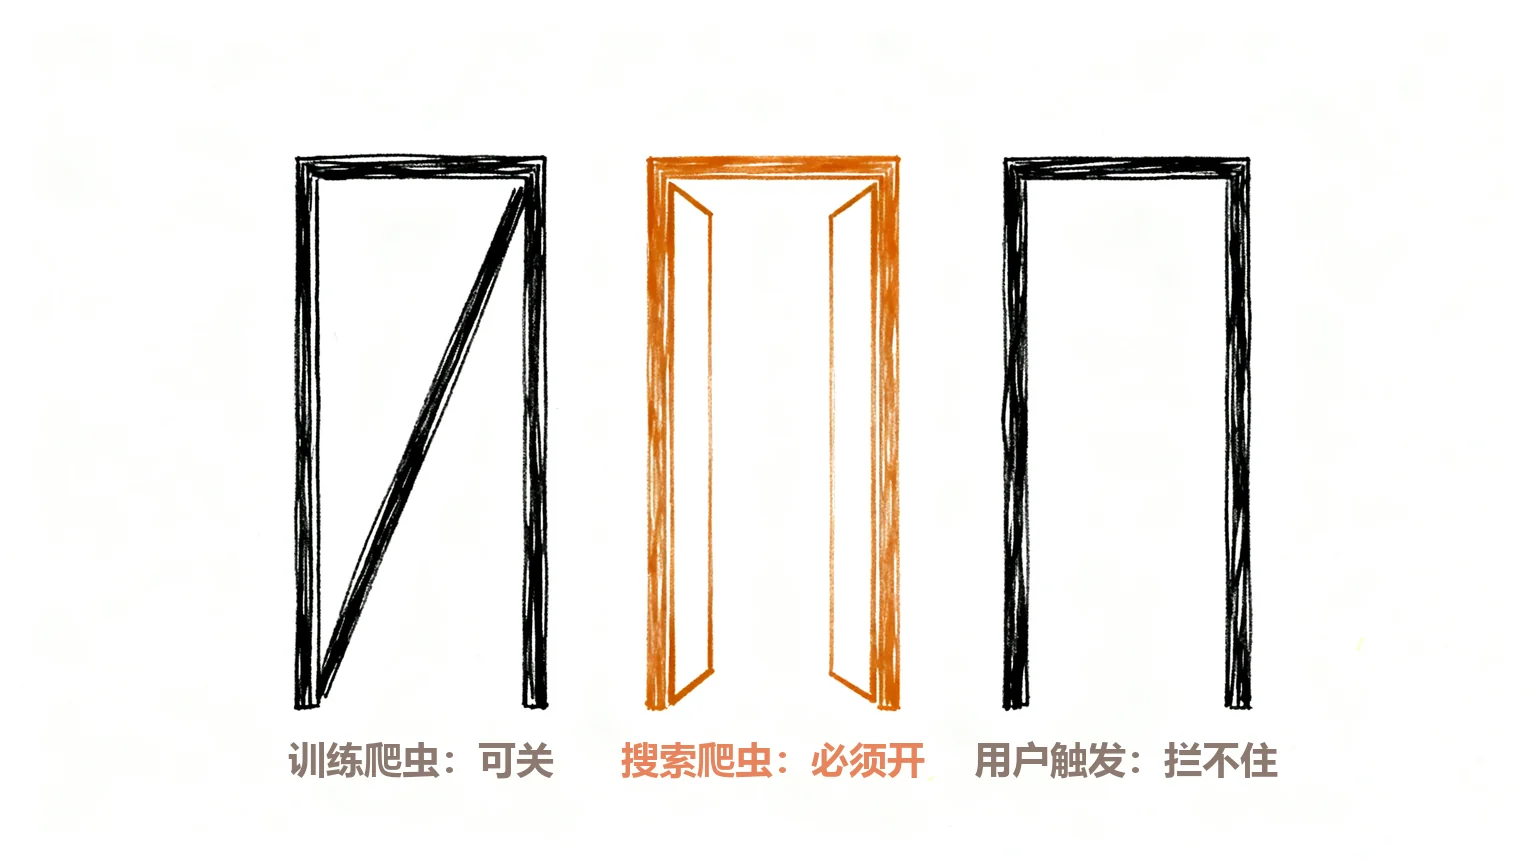
AI 的爬虫不是一种,是三种。而且这三种管的根本不是同一件事。
| 类别 | 代表 | 它干什么 | 你关了它会怎样 |
|---|---|---|---|
| 训练爬虫 | GPTBot(OpenAI)、ClaudeBot(Anthropic)、Google-Extended(Google)、CCBot(Common Crawl) |
收集内容,训练未来的模型 | 不影响你现在被引用,只影响未来模型懂不懂你 |
| 搜索爬虫 | OAI-SearchBot、Claude-SearchBot、PerplexityBot |
建索引,供 AI 回答时检索引用 | ⚠️ 直接失去被引用的资格 |
| 用户触发 | ChatGPT-User、Claude-User、Perplexity-User |
用户在对话里点名要看你的页面时,实时去抓 | ⚠️ robots.txt 很可能管不了它 |
中间那一行和最后一行,是保命的两行。
第一个坑:一行把所有 AI 的 UA 全封
这是最常见、也最致命的错误。
有人听说"AI 在偷我内容",于是在 robots.txt 里写了一行全站禁止;或者在 CDN 后台点一下"阻止 AI 爬虫"。
后果是什么?
OpenAI 在官方文档里写得很清楚:被 OAI-SearchBot 选择退出的站点,不会出现在 ChatGPT 的搜索回答里。
Anthropic 那边列出的后果是:禁用 Claude-SearchBot,会阻止系统为搜索索引你的内容,可能降低你在用户搜索结果里的可见度。
所以——你以为你在保护内容,实际上是把自己从 AI 的答案池里删掉了,而且没有任何通知。
第二个坑:两个已经不存在的名字
如果你在网上(尤其是一些 2025 年的攻略)看到这两个:
User-agent: Claude-Web
User-agent: anthropic-ai
它们已经不在 Anthropic 当前的爬虫文档里了。 现在是 ClaudeBot、Claude-User、Claude-SearchBot 三个。
抄旧清单本身后果不重(多写两行而已),但它说明一件事:这份名单会变,至少每年对一遍官方文档。
第三个坑(最多人搞错):Google-Extended 不是 AI 概览的开关
网上流传一个说法:"想从 Google 的 AI 概览里消失,就把 Google-Extended 禁掉。"
这是错的。
Google-Extended 甚至没有自己独立的爬虫身份——它不是一个会来访问你网站的机器人,它只是 robots.txt 里的一个控制令牌。它管的是:被抓到的内容,能不能用于训练未来的 Gemini 模型。
而"AI 概览""AI 模式"是 Google 搜索的功能,用的是 Googlebot 抓下来、正常进搜索索引的内容。
所以关掉 Google-Extended,你既没有退出 AI 概览,也没有保住任何东西——只是退出了 Gemini 的训练。而 Google 官方明说:Google-Extended 不影响网站在 Google 搜索中的收录,也不是排名信号。
真的想限制 AI 概览显示你的内容,官方给的控件是这四个:nosnippet、data-nosnippet、max-snippet、noindex。
⚠️ 但这四个是双向刀——它们同样会限制你在普通搜索结果里的摘要显示。这不是一个能两全的选择。
可直接照抄的 robots.txt
下面这份可以直接改。每一行是干什么的,我都写在注释里了。
# ========== 搜索爬虫:必须放行 ==========
# 这几个决定你能不能进入 AI 的答案池
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# ========== 常规搜索引擎:必须放行 ==========
# Google 的 AI 概览和 AI 模式,走的就是 Googlebot 的索引
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# ========== 用户触发抓取:拦不住,但要表态 ==========
User-agent: ChatGPT-User
Allow: /

User-agent: Claude-User
Allow: /

# ========== 训练爬虫:看你的立场 ==========
# 关掉它们 = 不让内容用于训练未来模型
# 关掉它们 不等于 从 AI 搜索里消失
# 纯商业站:开不开都行;内容本身就是产品的站:可以关
# 要关就把下面这一组里的 Allow: / 逐行改成 Disallow: /
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: CCBot
Allow: /

# ========== 全站兜底 ==========
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /cart/
Disallow: /checkout/

Sitemap: https://你的域名/sitemap.xml
怎么确认爬虫真的进来了
写完 robots.txt 不算完,因为你的 CDN、WAF、建站插件都可能在 robots.txt 之外再拦一道。
两个办法:
办法一,看服务器日志。 搜 OAI-SearchBot、Claude-SearchBot、PerplexityBot,看有没有访问记录。没有访问记录,就是门关着。
办法二,核对 IP,不要只看 UA。
为什么?因为 UA 名可以伪造。任何程序都能在请求头里写上 GPTBot,白拿你给 OpenAI 开的权限。
可靠的验证是 IP。OpenAI 和 Anthropic 都公开了各自的 IP 段(JSON 格式),下载下来和日志里的来源 IP 对一遍即可。
这不是纸上担心。2026 年 4 月,Cloudflare 就公开指控 Perplexity 使用未公开的爬虫访问站点——"只看 UA 名不够"是有现实版本的。
第一层:AI 读到的只有 HTML
第二个必须确认的事:AI 抓到你之后,到底看到了什么?
先看三组实测。看完你就明白,为什么这件事比 Schema 重要一百倍。
| 谁测的 | 怎么测的 | 结果 |
|---|---|---|
| searchVIU(2025 年 10 月) | 把一个产品价格用 8 种不同方式埋进页面,让 5 个 AI 系统去抓 | 没有任何一个系统,提取出"只存在于结构化数据里"的价格 |
| Vercel | 分析真实爬虫流量,看它们下不下载、执不执行 JavaScript | 主流 AI 爬虫都不执行 JavaScript。GPTBot 会下载 JS 文件(约 11.5% 的请求),ClaudeBot 也会(约 23.8%)——但一个都不执行 |
| Otterly AI | 把事实只放进 FAQ 结构化数据里,然后去问模型 | 没有任何平台把那些事实提取出来 |
三个不同的机构,三种不同的测法,指向同一件事:
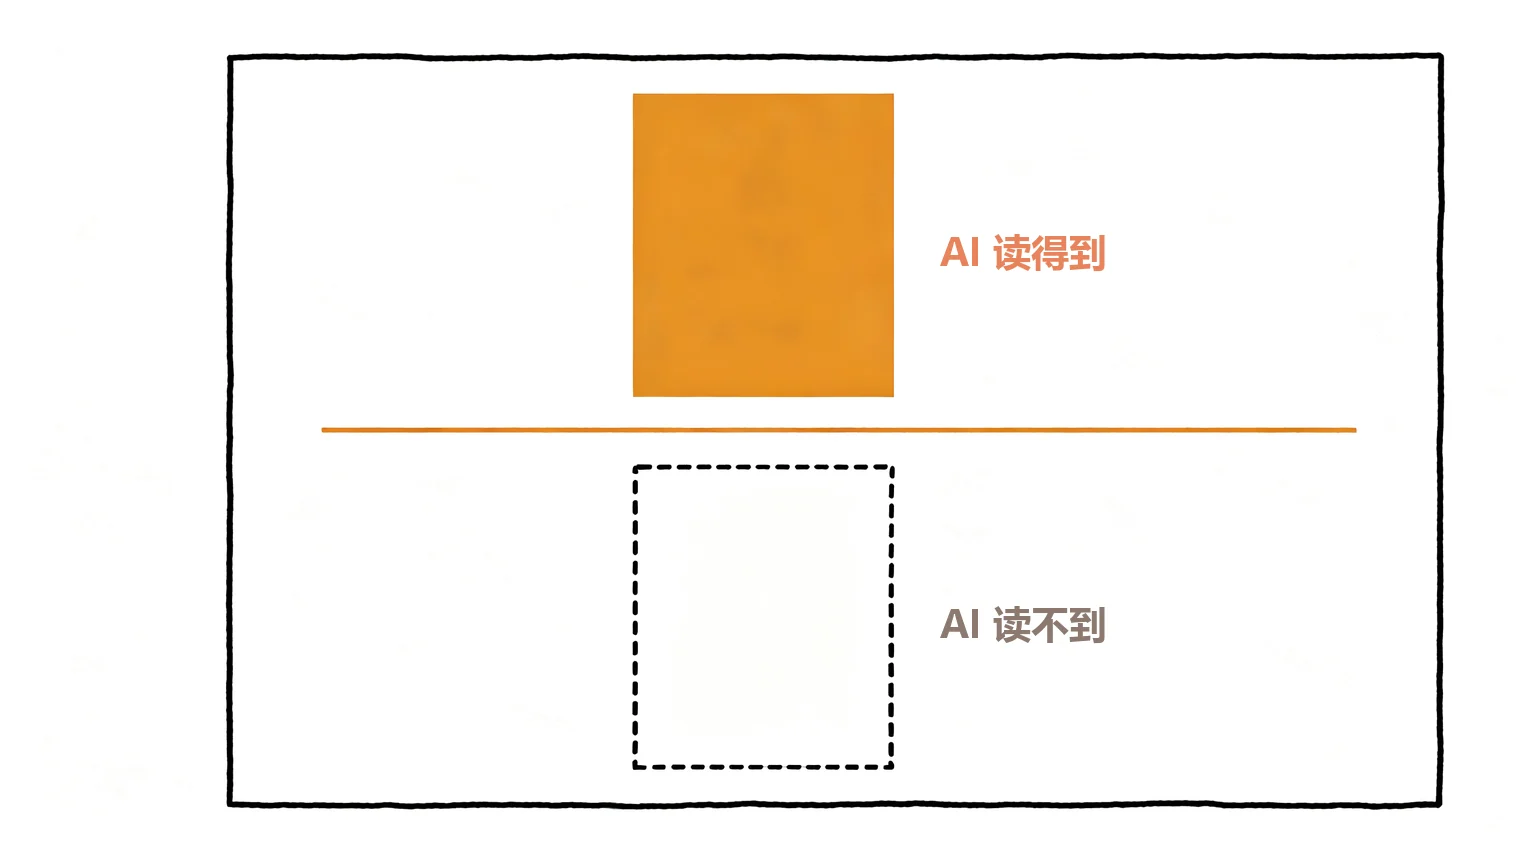
⭐ AI 读到的,是你页面上"渲染完的、可见的 HTML 文本"。不是你的标记。
标记在流程里的位置是更后面——它是在 AI 已经读到之后,用来确认这些内容该记在谁头上的。
于是有三个"不存在":
参数写在图片里的,不存在。 参数印在产品图上,人看着清楚,AI 看不到,它不会去"读"你的图。
参数只在 PDF 里的,不存在。 除非 AI 自己下载那个 PDF,而它通常不会。
靠 JavaScript 渲染出来的,不存在。 这是最隐蔽的一种:你在浏览器里看一切正常,因为你的浏览器执行了 JS。AI 的爬虫不执行。
怎么自查?一分钟后你就知道
在浏览器里禁用 JavaScript,打开你最重要的那个产品页。
方法:Chrome 设置 → 隐私和安全 → 网站设置 → JavaScript → 选"不允许网站使用 JavaScript"。或者装个一键开关的扩展。
然后看:还剩什么?
如果参数、尺寸、材质、认证、退换政策全都不见了——那么 AI 看到的,也是这个。
产品数据"事实化":改前与改后
下面这份对照表可以直接照着改。原则只有一条:
⭐ 每一个数字,都必须和它的字段名,写在同一个句子里。
| 改前(AI 读不懂) | 改后(AI 读得懂) |
|---|---|
产品图上印着 1000 |
最小起订量(MOQ):1000 件 |
页面上一个徽章写着 CE |
认证:CE 认证,符合欧盟机械指令 2006/42/EC |
表格里一列 15-25 |
交货期:15–25 个工作日,收到定金后起算 |
| 一排客户 logo 图 | 主要客户:德国、荷兰、波兰 12 家工业经销商,平均合作 3 年以上 |
| 参数表截图 | 材质:45 号碳钢;表面处理:镀锌;承重:2 吨;净重:3.2 公斤 |
| "高品质,值得信赖" | 出厂前 100% 承重测试,随货附测试报告,历史不良率 0.3% |
最后一行你可能会想:这不就是文案问题吗?
它确实是。但你要理解:AI 判断一个页面值不值得引用,看的就是这种"能不能被单独摘出来当答案"的句子。 "高品质值得信赖"摘不出任何东西;"不良率 0.3%,随货附测试报告"可以。
⚠️ 顺手纠一个正在中文技术圈传的说法。
我常看到这样的表述:「把产品参数用结构化数据标记出来,让 AI 准确读取你的参数。」
这个说法把因果搞反了。 结构化数据不是让 AI"读到"参数的手段——AI 读的是可见 HTML。它是让机器确认这些参数该记在谁头上的手段。
网上还有个很生动的抱怨:页面上写着 1000,AI 分不清那是起订量还是工作压力。
这个问题是真的。但它的解法不是加 Schema,而是把字段名写进去——把 1000 改成 起订量(MOQ):1000 件。
加 Schema 治不了这个病,改文案能治。
第二层:Schema 和 llms.txt 为什么不是抓手
现在讲加分层。先说两个"最像抓手"的东西。
先说 llms.txt
它是什么?一句话:放在你网站根目录的一个 Markdown 文件,用来告诉 AI"我站里哪些内容最重要"。
它是 2024 年 9 月由 Answer.AI 的 Jeremy Howard 提出的一个社区提议。注意,是提议,不是标准——没有 W3C、IETF 之类的机构背书,也没有任何一家大模型厂商公开承诺会读它。
那有没有人读?有人专门数了。
2026 年 6 月,Ahrefs 分析了 137,210 个域名的服务器日志和真实流量:
| 项目 | 数字 |
|---|---|
| 发布 llms.txt 的域名比例 | 28%(Ahrefs 自己说明这是上限,因为它客户偏技术向) |
| 这些文件里,当月收到零请求的比例 | 97% |
| 有请求的那 3% 里,来自 bot 的比例 | 96% |
| 真正的 AI 检索 bot(会产生引用的那种)占比 | 1.1%——整个研究里一共 233 次抓取 |
| 请求量最大的来源 | SEO 审计工具,21.7% |
还有三个数字特别值得看:
- Slackbot 抓 llms.txt 的次数,比 PerplexityBot 还多。 有人在群里贴了个链接,产生的流量比这个文件本来要服务的那个产品还多。
- 训练爬虫抓它的频率,大约是检索 bot 的 5 倍。 方向正好是反的。
- 对"根本不存在"的 llms.txt 的 404 请求里,AI bot 占比为 0。 没有任何一个 AI 会主动去找这个文件。
Google 的 John Mueller 被问到这件事时说得更直接:llms.txt "不是为搜索做的",它是给 AI 编程工具解析开发者文档用的"临时拐杖"。
⚠️ 但这里必须说清一件事,否则就变成另一种误导:
llms.txt 不是骗局,它只是用错了地方。
它真正的用途是面向开发者的文档站。Anthropic、Cloudflare、Cursor 这些公司都在自己的文档域名上放这个文件——因为当一个编程助手要来对接你的 API 时,一份 Markdown 索引确实比让它爬 400 个 HTML 页面便宜得多。
它帮的是一个"已经决定要用你网站"的助手;它不帮一个"还没听说过你"的引擎做决定。
所以判据很简单:你卖不卖 API、有没有技术文档站? 有,自己花十分钟写一份;没有,就别为它花钱。
再说 Schema
Schema(结构化数据)的历史长得多,它是为了让搜索引擎理解"这个字符串是价格、那个数字是评分"而发明的,已经有十几年。
那它对 AI 引用有没有用?
2026 年 5 月,Ahrefs 做了一次受控实验——这是这个问题上目前公开证据里最干净的一次。
做法:找出 1,885 个在 2025 年 8 月到 2026 年 3 月之间新增了结构化数据的页面,给每一个配大约 3 个"同站点或同主题、但没加"的对照页(共约 4,000 个)。比较加之前 30 天和加之后 30 天的引用变化。
结果:
| 平台 | 引用变化 |
|---|---|
| Google AI 概览 | −4.6%(唯一统计显著的,而且是往下的) |
| Google AI 模式 | +2.4%(与零没有区别) |
| ChatGPT | +2.2%(与零没有区别) |
另一份研究的视角不同。Kurt Fischman 在 2026 年 2 月发表的论文,收集了 730 条 AI 引用(用 ChatGPT 和 Gemini 各跑 75 个商业查询),再找 1,006 个对照页比对。
它给出的三档更直观:
| 页面的结构化数据情况 | AI 引用率 |
|---|---|
| 完全不加 | 59.8% |
| 加了,但是建站工具默认生成的那种通用标记 | 41.6% |
| 加了,而且字段具体(商品/评价类,带价格、评分、规格) | 61.7% |
⭐ 中间那一行是重点:加了"通用标记",引用率比完全不加还低 18 个百分点。
合理解释是:一份空着关键字段的通用标记(比如 Organization 的网址字段是空的、文章作者写着"admin"),在机器看来是一个"这个站想用结构化数据,但没维护好"的信号。
⚠️ 但这里有两条自我限定,不然我就是在重复自己批评的那种做法:
第一,结论不能推得太远。 Ahrefs 自己明确写了:它测的全都是本来就已经被引用(AI 概览引用 100 次以上)的页面。它证明的是"给已经上道的页面加标记,没有明显提升",它没有证明"标记对一个从来没被引用过的新页面没用"。
第二,所有日志类数字都是"上界"。 Ahrefs 自己写了:"被抓取"不等于"被读过"。真实数字只会更小。
但 Schema 有一小块仍然值得做
讲完"不是抓手",得把话说全:Schema 不是别做了,是别指望它当发动机。
它真正值得做的地方只有一块,而且是 Ahrefs 自己都留了口的那一块:发现阶段。
Ahrefs 在结论里写了一句:结构化数据对已经被引用的页面没有额外好处,但对还没被抓取或解析的页面,在爬取和索引环节起作用,"仍然是一个合理的假设——只是这两份研究没测这个"。
换句话说:它的战场在"被理解",不在"被引用"。
而"被理解"这件事里,目前最值得做的是四个字:实体消歧。
为什么要消歧? 大模型靠"实体"组织知识。你的品牌名如果只是一个孤立的字符串,它就是一个模糊的引用;如果它能被连到一个明确的知识来源上,它就是一个已知实体。
Organization(组织)+ sameAs(指向同一身份的其他资料来源)就是做这件事的。
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://你的域名/#organization",
  "name": "公司法定名称",
  "alternateName": "品牌简称(客户平时怎么叫你)",
  "url": "https://你的域名",
  "logo": "https://你的域名/logo.png",
  "description": "一句话说明你是做什么的、为谁服务",
  "foundingDate": "2015",
  "address": {
    "@type": "PostalAddress",
    "streetAddress": "详细地址",
    "addressLocality": "城市",
    "addressCountry": "CN"
  },
  "sameAs": [
    "https://www.wikidata.org/wiki/Q你的ID",
    "https://www.linkedin.com/company/你的页面",
    "https://www.youtube.com/@你的频道"
  ],
  "knowsAbout": [
    "你的核心品类词",
    "你的核心技术或工艺",
    "你服务的行业"
  ]
}
三点说明:
@id 要稳定。 它是这个实体在你网站上的唯一标识,别今天换一个明天换一个。
sameAs 里的每一个链接,都要真的能打开。 打不开的等于没有。
每个页面都引用同一个 @id。 首页、产品页、关于页都指向同一个组织实体,机器才能把它们串成同一个"你"。
⚠️ 顺便记住一条硬规则,这是 Google 在结构化数据上唯一一条跟 AI 有关的警告:
⭐ 结构化数据必须和页面上看得见的内容一致。
标了价格,页面上就得有那个价格;标了评分,页面上就得有那个评分。不一致不是"优化没做到位",是"垃圾信号"。 所以查出来不一致的字段,正确动作是删掉,不是补上。
⚠️ 还有一条 2026 年的变化,特别容易被误传:
FAQ 富结果已经在 2026 年 5 月 7 日被 Google 完全下线了(HowTo 更早)。
但下线的只是"搜索结果里那个折叠问答的展示效果"——标记本身仍然有效,不会被惩罚。
所以你不需要专程去删掉 FAQ 标记。你只需要停止为它付钱。
真正的增量,已经不在你的网站上
现在讲这一篇里我最想让你记住的东西。
前面所有的内容都在讲"怎么让 AI 理解你"。但从 2026 年开始,独立站多了一个比 Schema 硬得多的入口,而且它直接连钱。
先看时间线:
| 时间 | 发生了什么 |
|---|---|
| 2026 年 1 月 | Google 宣布数十个新的商家中心(Merchant Center)数据属性,专为对话式商务设计 |
| 2026 年 4 月 | AI Max 扩展到标准购物广告,直接用产品数据里的材质、版型等字段生成文案 |
| 2026 年 5 月 | Google 公布 AI 模式全球月活超过 10 亿 |
| 2026 年 5 月 | Google Marketing Live 发布 对话式属性,其中问答、相关产品、文档链接三项是全新字段 |
对话式属性是什么?就是 Google 给"喂给 AI 的商品数据"定了新格式。
Google 点名与 AI 界面相关的 8 个属性:
- 产品亮点
- 产品细节
- 变体选项
- 同组商品标题
- 相关产品
- 问答
- 文档链接
- 热度排名
门槛也给了:
- 商品标题至少 30 个字符
- 商品描述至少 500 个字符
- 有 GTIN 的尽量都填
⚠️ 注意那个 500 字符。很多独立站的商品描述只有一句话加三个卖点。那不是"写得简练",那是"对 AI 来说信息量为零"。
为什么我说这件事比 Schema 硬得多?
因为 Google 给的是钱的数字,不是引用率:
- ⭐ 采用核心数据最佳实践的商家,下个月转化平均提升 5%
- ⭐ 与 Lululemon 的测试里,零售商提交的对话式属性,在 AI 模式的相关产品推荐中被采用的比例达到 50%
一个说的是"AI 引用率"(很难归因到收入),另一个说的是"下个月转化提升 5%"。哪个更值得投入,你自己判断。
配套设施 Google 也建好了:通用商务协议(UCP) 让 AI 能直接在 AI 模式和 Gemini 里完成购买;Business Agent 是 Google 的虚拟销售助手,它回答产品问题的依据,就是你在商家中心里提交的数据;背后那个商品知识图谱有 500 亿件商品,每小时刷新 20 亿次。
已经有人在用了:Tapestry(Coach、Kate Spade 的母公司) 用它把商品铺到了 Google 搜索(含 AI 模式)和 Gemini 应用上。
你的动作很简单: 如果你做 Google 渠道,去商家中心后台,把商品标题补到 30 字符以上、描述补到 500 字符以上、能填的编码补齐,然后找一找"对话式属性"那一栏。
⚠️ 最后一条纪律:数据表里的信息,必须和产品页上写的一模一样。 价格、库存、参数,任何一处不一致,都会被判定成"这个数据源不可靠"。这比"没填"更糟。
门不只在你自己的 robots.txt 里
这一节讲一件你可能已经中招但完全不知道的事。
Cloudflare 在 2026 年 7 月宣布了一套新政策,9 月 15 日起生效:
对新接入的域名,在有广告的页面上——训练类爬虫和 Agent 类爬虫默认阻断,搜索类爬虫默认放行。
听起来挺合理。问题在下面这一条:
⚠️ 这个阻断设置适用于"混合用途爬虫"——而名单里包括 Googlebot、Applebot、Bingbot。
也就是说:你想挡住训练,有可能连搜索一起丢掉。 因为 Googlebot 同时干"为搜索抓取"和"为 AI 提供数据"两件事,从外面看就是同一个爬虫。
Cloudflare 也知道这个问题,所以给了一个新开关:允许你在保留搜索的同时拒绝训练。 但它自己注明了一个限制——对必应,要等到 2027 年初才能通过 robots.txt 生效。
顺带说一句商业侧的变化:Cloudflare 的"按抓取付费"已经改名"按使用付费",逻辑是"一个页面可能只被爬一次,却被引用上千次,按抓取计费不合理"。
为什么这一节对独立站老板重要?
因为量级摆着:大约 16% 的全球互联网流量经过 Cloudflare,而它自己的数据说,机器人已经占了全部网页请求的一半以上。
更关键的是——门不只在这一处。
下面这四个地方,都可能在你的 robots.txt 之外把 AI 挡掉,而且它们改动时不会通知你:
- CDN 的默认规则(除了 Cloudflare,别家也有类似开关)
- WAF 或安全防护(很多"企业级防护"默认就把大量机器人拦了)
- 建站模板和插件(有些 SEO 或安全插件带"阻止 AI 爬虫"的开关,默认是开的)
- 服务器的缓存和限流规则(限得太狠时,爬虫会被当成攻击流量)
所以本节的自查动作是: 去你自己的 CDN、防护后台、建站插件里,把 AI 爬虫的真实放行状态看一遍。
不要看说明书,看日志。日志里有访问记录,才是真的开着。
把这一篇出现的词,一次性翻成人话
| 词 | 人话 |
|---|---|
| 爬虫(crawler / bot) | AI 派来读你网站的机器人程序 |
| robots.txt | 放在你网站根目录的一个纯文本文件,告诉爬虫"哪些能读、哪些别读" |
| UA(User-Agent) | 爬虫来访时自报的名字,比如 GPTBot。⚠️ 可以伪造,不能只信它 |
| 训练爬虫 | 把内容收走训练未来模型的爬虫 |
| 搜索爬虫 | 建索引、供 AI 回答时引用你内容的爬虫。关了就等于退出答案池 |
| 用户触发抓取 | 用户当面要求 AI 去看某个页面时,临时发起的抓取 |
| 混合用途爬虫 | 同一个爬虫既为搜索抓取、也为 AI 提供数据(Googlebot、Bingbot 都属于这类) |
| 渲染 | 把 JS 代码跑完、生成最终页面的过程。⚠️ 主流 AI 爬虫都不做这一步 |
| 服务端渲染 | 让服务器直接把完整页面发给访问者,不依赖浏览器跑 JS |
| 结构化数据 / Schema | 一段写在网页里、专门给机器看的"标签",说明每一块内容是什么 |
| 实体消歧 | 让机器确认"这个名字指的是哪个具体主体" |
| sameAs | 结构化数据里的一个字段,列出"同一个身份"在其他平台的页面 |
| llms.txt | 放在网站根目录的 Markdown 索引文件,本来是给编程助手看文档用的 |
| 商品数据表(feed) | 你提交给 Google 商家中心的商品数据 |
| 对话式属性 | Google 2026 年新增的一类商品数据字段,让 AI 能读懂你的商品细节 |
《独立站 AI 可读性自查清单》
这一篇的清单,分四层,一共 19 项。
顺序很重要:前两层没做完,不要开始第三层。
第 0 层 · 10 分钟 · 先确认门是开的(5 项)
- [ ] 浏览器访问
你的域名/robots.txt,确认OAI-SearchBot、Claude-SearchBot、PerplexityBot、Googlebot、Bingbot没有被禁止 - [ ] 确认全站兜底规则里,没有"一行全封"这种写法
- [ ] 登录 CDN 后台,找到机器人管理,确认搜索类爬虫是放行的
- [ ] 检查建站插件(SEO 类、安全类)里有没有"阻止 AI 爬虫"的开关,现在是什么状态
- [ ] 翻服务器日志,搜
OAI-SearchBot,看最近 30 天有没有访问记录
第 1 层 · 半天 · 确认 AI 能读到东西(5 项)
- [ ] 禁用 JavaScript,打开最重要的产品页,看参数还在不在
- [ ] 如果参数不在:确认产品页是服务端渲染还是前端渲染,改成前者
- [ ] 检查关键参数是否印在图片里(如果是,抄进正文)
- [ ] 检查技术资料是否只以 PDF 形式提供(如果是,在页面上补一份文字摘要)
- [ ] 用 Google Search Console 的"网址检查",看搜索引擎抓到的页面长什么样
第 2 层 · 一天 · 把产品数据改成 AI 读得懂的写法(5 项)
- [ ] 每个数字配上字段名(
1000→最小起订量:1000 件) - [ ] 认证写全称加标准号(
CE→CE 认证,符合欧盟机械指令 2006/42/EC) - [ ] 交期写成范围加起算点(
15-25→15–25 个工作日,收到定金后起算) - [ ] 参数表从截图改成网页表格
- [ ] 商家中心里:标题补到 30 字符以上、描述补到 500 字符以上、编码补齐
第 3 层 · 可选 · 别花钱的那部分(4 项)
- [ ] 结构化数据只做 Organization + 稳定标识 + sameAs(模板见上一节),全站引用同一个标识
- [ ] 检查已有标记:有没有空字段、有没有和页面可见内容不一致(不一致的要删掉,不是补上)
- [ ] llms.txt:只在你有技术文档站时才写,自己花十分钟写,不为它付钱
- [ ] 每年核对一次爬虫名单(官方文档会变,
Claude-Web就是这么过期的)
自查结果记录表(留档用)
| 层级 | 检查项 | 结果 | 发现的问题 | 处理日期 |
|---|---|---|---|---|
| 第 0 层 | 搜索爬虫是否放行 | |||
| 第 0 层 | CDN / 插件是否挡了 AI | |||
| 第 1 层 | 关 JS 后参数是否可见 | |||
| 第 2 层 | 数字是否带字段名 | |||
| 第 3 层 | 标记是否与页面一致 |
⚠️ 这张表里"发现的问题"那一栏,不要留空。如果四层查下来一片绿,那更可能是你查得不够细。
本节动作
五分钟。做完这一件事,你就知道自己的站在哪一层:
打开浏览器,禁用 JavaScript,然后打开你最重要的那个产品页。
把页面上的参数逐条抄到一张纸上。
抄不出来的那些,就是对 AI 也不存在的那些。
GEO 实验日志 · 第 13 期
这一期我拿一个客户的独立站做了三层体检,记录如下。
第 0 层(爬虫):robots.txt 本身没问题,但他用的建站模板自带一个"安全加固"插件,默认按 UA 拦了一批机器人。日志里搜 OAI-SearchBot——30 天零访问。
第 1 层(可读性):产品页是前端渲染。禁用 JS 之后,参数区只剩一个空框。12 个核心产品,全部如此。
第 2 层(事实化):他的参数其实都有,只是全部印在产品图上——因为"这样页面好看"。我们花半天把它们抄进了网页表格。
第 3 层什么都没买。
一个月后回头看:AI 来源的访问从 0 变成了个位数。数字很小,但它是从 0 到 1。
而在此之前,他花两万块买的"GEO 优化包",一个访问都没带来。
写在最后
这一篇讲的东西,说白了就一句:
内容再好,爬虫进不来、数据读不懂,等于零。
这件事最容易出错的地方在于——它不出错在难的地方,出错在没人看的地方。 robots.txt 没人天天看,CDN 后台的默认值没人改,产品图好看就够了。
所以顺序是:先开门,再清扫,最后装修。
Schema 要加就加,llms.txt 想发就发。但先确认 AI 能进得来。
下一篇我们进内容层:产品页到底怎么写,才让 AI 愿意摘你那段话——以及出海这条线,效果到底怎么证明。
觉得有用就点个赞、在看吧——顺手做个小动作:打开浏览器禁用 JavaScript,看看你最重要的那个产品页还剩什么。
这一篇读完,你应该能做到: 分清 AI 爬虫的三种类别(训练 / 搜索 / 用户触发)以及关掉各自会有什么后果;知道 Google-Extended 不是 AI 概览的开关、Claude-Web 已经过时;确认自己站点的 CDN、防护插件没有在你不知情的时候把搜索类爬虫挡掉;明白 AI 读到的是渲染后的可见页面而不是标记,并用"禁用 JavaScript"一分钟自查出哪些参数对 AI 不存在;把产品参数改成"每个数字都带字段名"的写法;用《独立站 AI 可读性自查清单》(四层 19 项 + robots.txt 模板 + Organization 标记模板 + 留档记录表)在两天内给独立站做完一次技术层体检,并且清楚哪一层不用花钱。
下一篇预告: 第 14 篇《独立站 GEO:内容怎么写,效果怎么证明》——技术底座修好了,AI 能进来了,接下来是它愿不愿意摘你。下一篇给两样东西:一套出海版的内容写法(结论前置、FAQ 答案控制在多长、对比表为什么最容易被摘),和一套能写进合同的验收方式(哪些后台能直接看到 AI 来源、怎么把"被引用"和"被访问"分开算)。